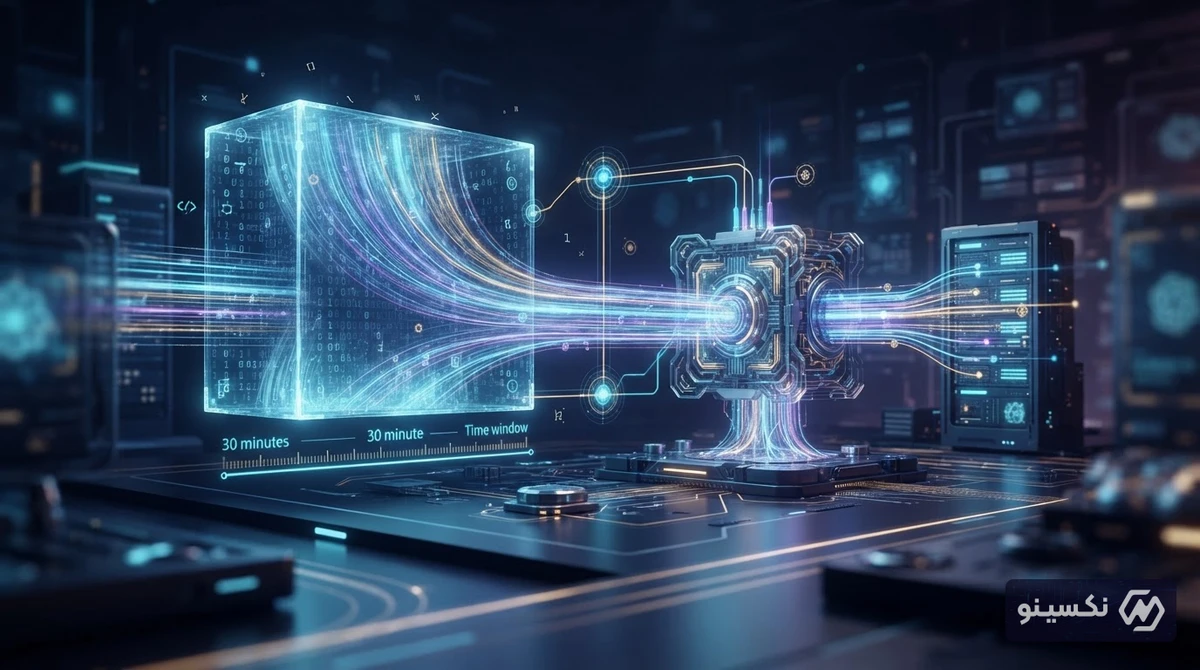
اوپنایآی (OpenAI) در جدیدترین گام خود برای تسهیل اجرای عاملهای هوشمند و کاهش هزینههای پردازش ابری، از ارتقای بنیادین سیستم «کش پرامپت» (Prompt Caching) برای خانواده مدلهای GPT-6 رونمایی کرد. این فناوری پیشرفته به سیستمهای هوش مصنوعی اجازه میدهد بخشهای تکراری دادههای ورودی را ذخیره کرده و علاوه بر بهبود چشمگیر زمان پاسخدهی، تخفیف خیرهکننده تا ۹۰ درصد را در هزینه توکنهای ورودی برای توسعهدهندگان به ارمغان آورد.
چرا سیستم کش پرامپت در نسل GPT-6 نقشی حیاتی دارد؟
با ورود هوش مصنوعی به دوران عاملهای مستقل و خودکار (Autonomous Agents)، سناریوهای کاری تغییر کردهاند. عاملهای مبتنی بر GPT-6 اکنون میتوانند ساعتها بهطور پیوسته روی پروژههای پیچیدهای مانند بازنویسی و ریفکتور کدهای نرمافزاری عظیم، تحلیل دادههای جامع و تدوین پژوهشهای چندمرحلهای فعالیت کنند. این فرآیندها مستلزم ارسال درخواستهای مکرر به API هستند؛ درخواستهایی که در آنها دستورالعملهای سیستمی، تعاریف ابزارها و تاریخچه مکالمات بهصورت مداوم تکرار میشوند.
پردازش مجدد این حجم انبوه از اطلاعات ثابت در هر مرحله، هم منابع سرور را هدر میدهد و هم سرعت پاسخدهی را کند میکند. سیستم کش پرامپت با ذخیرهسازی این پیشوندهای مشترک، پردازش محاسباتی تکراری را حذف کرده و مدل را قادر میسازد بلافاصله سراغ تحلیل دادههای جدید برود.
نوآوریهای فنی در کش پرامپت GPT-6
اوپنایآی در این بهروزرسانی، نرخ موفقیت کش (Cache Hit Rate) را بهصورت پیشفرض افزایش داده و پنجره زمانی استفاده مجدد از حافظه موقت را به ۳۰ دقیقه ارتقا داده است. این یعنی اگر عاملی طی نیم ساعت به کانتکست قبلی ارجاع دهد، شامل بالاترین سطح تخفیف محاسباتی و کمترین تأخیر زمانی خواهد شد.
| قابلیت | سیستم سنتی / نسلهای گذشته | سیستم کش پرامپت GPT-6 |
|---|---|---|
| تخفیف توکنهای کششده | محدود یا بدون تخفیف پویا | تا ۹۰ درصد تخفیف روی توکنهای ورودی واجد شرایط |
| پنجره زمانی معتبر | کوتاهمدت و با نرخ ابطال بالا | ۳۰ دقیقه ماندگاری پیشوندهای مشترک |
| تغییر سطح استدلال (Reasoning) | ابطال کامل حافظه کش | امکان تغییر سطح تفکر بدون از دست رفتن کش |
| ابزارهای عیبیابی | گزارشهای کلی و مبهم | داشبورد تحلیلی و ابزار اختصاصی خطایابی کش |
ابزارهای جدید نظارت و خطایابی: کنترل کامل در دستان مهندسان
یکی از بزرگترین چالشهای توسعهدهندگان در استفاده از کشینگ، شناسایی علت دقیق عدم استفاده از کش (Cache Miss) بود. اوپنایآی همزمان با معرفی این قابلیت، دو ابزار کلیدی را در دسترس قرار داده است:
- داشبورد اختصاصی کش پرامپت (Prompt Caching Dashboard): این ابزار به تیمهای فنی اجازه میدهد نسبت توکنهای کششده به توکنهای پردازششده تازه را پایش کرده و بازدهی مالی و سرعتی سیستم را در طول زمان بسنجند.
- ابزار تشخیص خطای کش (Diagnostics Tool): این ابزار علت دقیق ناکام ماندن کش (مانند تغییر جزئی در تعریف توابع، جابهجایی پارامترها یا تغییر سیستم پرامپت) را با ارائه گزارش ساختاریافته مشخص میکند تا مهندسان بتوانند ساختار کدهای خود را بهینهسازی کنند.
تنظیم پویای سطح استدلال بدون ابطال کش
در مدلهای پیشرفته خانواده GPT-6، قابلیت تنظیم «میزان تلاش برای استدلال» (Reasoning Effort) وجود دارد. در گذشته، اگر در طول یک گفتوگو سطح استدلال مدل تغییر میکرد، کش پیشین نامعتبر میشد و هزینه پردازش مجدد افزایش مییافت.
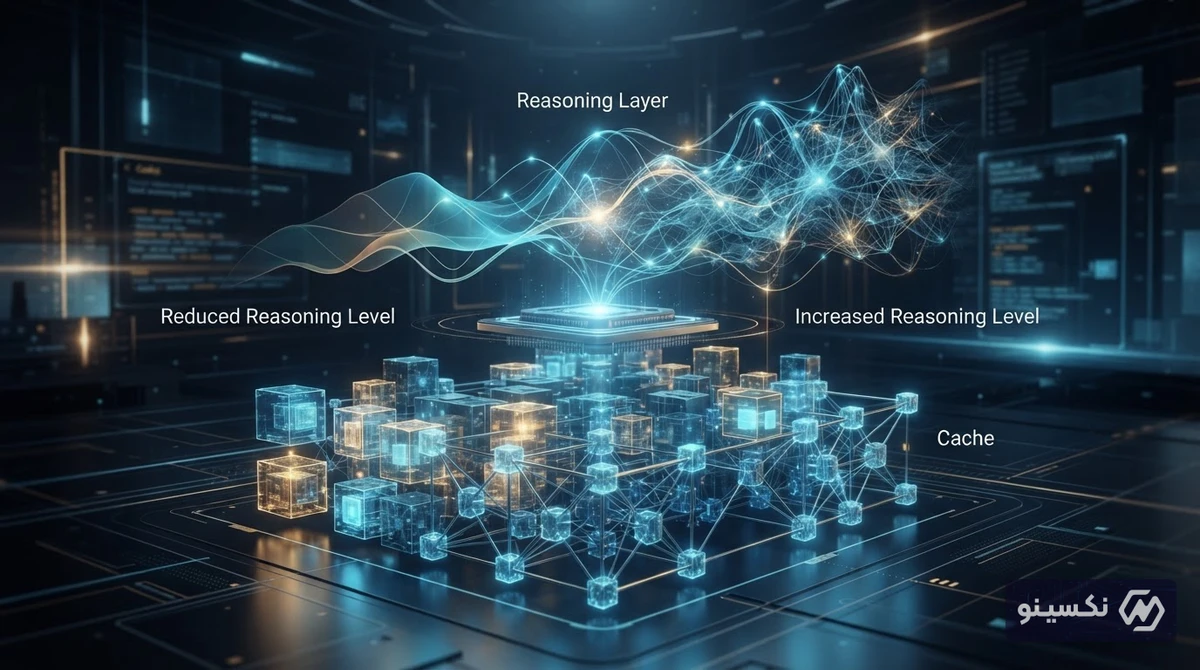
با معماری جدید، توسعهدهندگان میتوانند از طریق یک فرمان بهروزرسانی پیکربندی، قدرت استدلال مدل را برای کارهای سختتر افزایش و برای مراحل روتین کاهش دهند، بدون آنکه حافظه کش کانتکست قبلی از بین برود. این قابلیت باعث انعطافپذیری فوقالعاده عاملها در بهینهسازی مصرف انرژی و هزینه میشود.
تاثیر بر بازار هوش مصنوعی؛ تجربه گیتهاب کوپایلت
کاهش ۹۰ درصدی هزینهها صرفاً یک ارتقای فنی نیست، بلکه معادلات اقتصادی کسبوکارهای متکی بر هوش مصنوعی را بازتعریف میکند. نمونه بارز این موفقیت را میتوان در پلتفرم GitHub Copilot مشاهده کرد.
«سیستم کش پرامپت اوپنایآی نقشی اساسی در ارائه تجربهای سریع و مقیاسپذیر در گیتهاب کوپایلت ایفا میکند. طی ماههای گذشته، ما سهم توکنهایی را که نیازمند پردازش تازه بودند بیش از ۵۰ درصد در میان میلیاردها درخواست کاهش دادهایم؛ دستاوردی که نتیجه آن کاهش زمان پاسخ اولیه برای برنامهنویسان سراسر جهان بوده است.»
— ماریو رودریگز (Mario Rodriguez)، مدیر ارشد محصول در گیتهاب
راهکارهای عملی برای بهرهوری حداکثری از کش پرامپت
برای دریافت بیشترین نرخ کش و استفاده کامل از تخفیفهای GPT-6، رعایت موارد زیر به توسعهدهندگان توصیه میشود:
- تثبیت ساختار ابزارها: تعریف توابع و ترتیب ارسال آنها را ثابت نگه دارید و بهجای حذف ابزارها در میانه مکالمه، از قابلیت فیلتر ابزارهای مجاز استفاده کنید.
- افزودن دستورالعملها به انتهای پرامپت: برای تغییر رفتار مدل، دستورات جدید را به انتهای پیامها الحاق کنید تا ساختار پیشوند اصلی بدون تغییر باقی بماند.
- استفاده از نقاط شکست کش (Cache Breakpoints): با مشخصکردن بخشهای ایستا و پویای پرامپت، کش شدن بخشهای طولانی و بدون تغییر را تضمین کنید.
- پیشگرمسازی کش (Cache Prewarming): پیش از آغاز درخواستهای سنگین، کانتکست اصلی را در سرور بارگذاری کنید تا نخستین پاسخ با کمترین تأخیر ممکن دریافت شود.
جمعبندی
ارتقای سیستم کش پرامپت برای GPT-6 گامی بزرگ در مسیر تجاریسازی واقعی و مقرونبهصرفه عاملهای هوشمند است. با کاهش ۹۰ درصدی هزینههای توکن و ارائه ابزارهای نظارتی دقیق، اوپنایآی راه را برای پیادهسازی سیستمهای خودکار پیشرفتهتر هموار ساخته و کارایی محاسباتی را به استانداردی جدید در دنیای هوش مصنوعی تبدیل کرده است.
سؤالات متداول
سیستم کش پرامپت GPT-6 چیست و چگونه کار میکند؟
این سیستم با ذخیرهسازی پیشوندهای مشترک و تکراری در درخواستهای API، از پردازش مجدد دادههای ثابت جلوگیری کرده و زمان پاسخدهی را کاهش میدهد.
میزان تخفیف هزینه برای توکنهای کششده چقدر است؟
اوپنایآی برای توکنهای ورودی که از کش خوانده میشوند تا ۹۰ درصد تخفیف در هزینههای API اعمال میکند.
حافظه کش پرامپت تا چه مدت معتبر باقی میماند؟
در سیستم جدید GPT-6، پیشوندهای واجد شرایط تا ۳۰ دقیقه پس از آخرین استفاده در حافظه کش فعال میمانند.
آیا تغییر سطح استدلال در GPT-6 باعث ابطال کش میشود؟
خیر؛ با قابلیت جدید بهروزرسانی پیکربندی، توسعهدهندگان میتوانند میزان استدلال مدل را در میانه کار تغییر دهند بدون آنکه حافظه کش پیشین از بین برود.