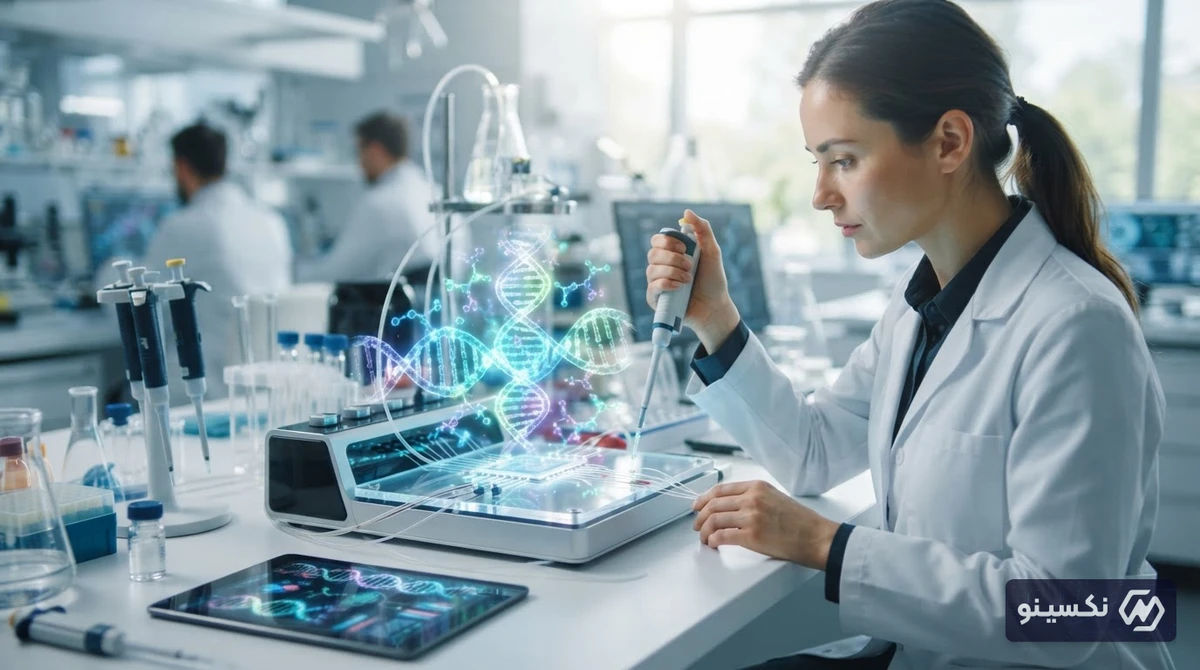
برای دههها، سیلیکون و پالسهای الکتریکی ستون فقرات عصر دیجیتال بودهاند، اما با نزدیکشدن تراشههای الکترونیکی به محدودیتهای فیزیکی قانون مور، دانشمندان به سراغ یکی از پیچیدهترین و کارآمدترین سیستمهای پردازشی جهان هستی رفتهاند: مولکولهای DNA. ورود زیستشناسی به حوزه پردازش داده، نویدبخش نسلی نوین از ابررایانهها است که میتوانند محاسبات پیچیده را با مصرف انرژی بسیار ناچیز و چگالی ذخیرهسازی باورنکردنی انجام دهند.
توسعه اولین سیستمهای محاسباتی مبتنی بر رشتههای دیانای نشان میدهد که آینده پردازش دیگر صرفاً در انحصار مهندسی الکترونیک نیست، بلکه با بیوتکنولوژی و شیمی آلی گره خورده است. این جهش علمی نه تنها چالشهای حرارتی و مصرف فزاینده برق در مراکز داده را حل میکند، بلکه افقهای جدیدی را در هوش مصنوعی، مدلسازیهای ژنتیکی و رمزنگاری دادهها میگشاید.
عبور از محدودیتهای سیلیکون؛ چرا دنیای فناوری به رایانش زیستی روی آورده است؟
صنعت نیمههادی با بحرانی خاموش مواجه است؛ کوچکتر کردن ترانزیستورها به ابعاد زیر ۲ نانومتر با پدیدههای کوانتومی ناخواسته و تولید حرارت سرسامآور روبهرو شده است. از سوی دیگر، انفجار دادههای دیجیتال و توسعه مدلهای حجیم هوش مصنوعی نیازمند مصرف گیگاواتها انرژی الکتریکی است. در این نقطه بحرانی، رایانش زیستی (Biocomputing) به عنوان راهکاری بنیادین ظاهر شده است تا منطق باینری کلاسیک را با فرآیندهای شیمیایی جایگزین کند.
رشتههای DNA در سلولهای زنده، میلیاردها سال وظیفه ذخیره و پردازش دستورالعملهای بیولوژیکی را بدون نیاز به منبع تغذیه پرمصرف انجام دادهاند. اکنون مهندسان توانستهاند با بازبرنامهریزی این مولکولها، فرآیندهای محاسباتی، منطق ریاضی و حتی ذخیرهسازی داده را روی بستری کاملاً ارگانیک پیادهسازی کنند.
کامپیوتر DNA چیست و چگونه بدون مدار الکتریکی کار میکند؟
در رایانههای معمولی، اطلاعات به صورت بیتهای صفر و یک (حالتهای خاموش یا روشن جریان برق) کدگذاری میشوند. در مقابل، یک کامپیوتر DNA از چهار بلوک ساختمانی اساسی ژنتیک شامل آدنین (A)، سیتوزین (C)، گوانین (G) و تیمین (T) برای رمزگذاری دادهها بهره میبرد.
الفبای ژنتیکی به جای کدهای دودویی
وجود چهار پایه شیمیایی به کامپیوترهای زیستی اجازه میدهد به جای سیستم دوتایی، از سیستم عددی بر پایه ۴ استفاده کنند. این امر ظرفیت ذخیره اطلاعات در واحد سطح را به طور چشمگیری افزایش میدهد. واکنشهای هیبریدیزاسیون (اتصال رشتههای مکمل DNA به یکدیگر) نقش گیتهای منطقی نظیر AND، OR و NOT را ایفا میکنند.
پردازش موازی فوقالعاده با واکنشهای مولکولی
مهمترین تمایز پردازندههای زیستی در قدرت «پردازش موازی انبوه» نهفته است. در یک لوله آزمایش حاوی تریلیونها قطره مایع، میلیاردها رشته DNA میتوانند به طور همزمان و مستقل با یکدیگر پیوند برقرار کرده و محاسبات متفاوتی را در کسری از ثانیه حل کنند؛ قابلیتی که پیشرفتهترین سوپرکامپیوترهای سیلیکونی جهان را به چالش میکشد.
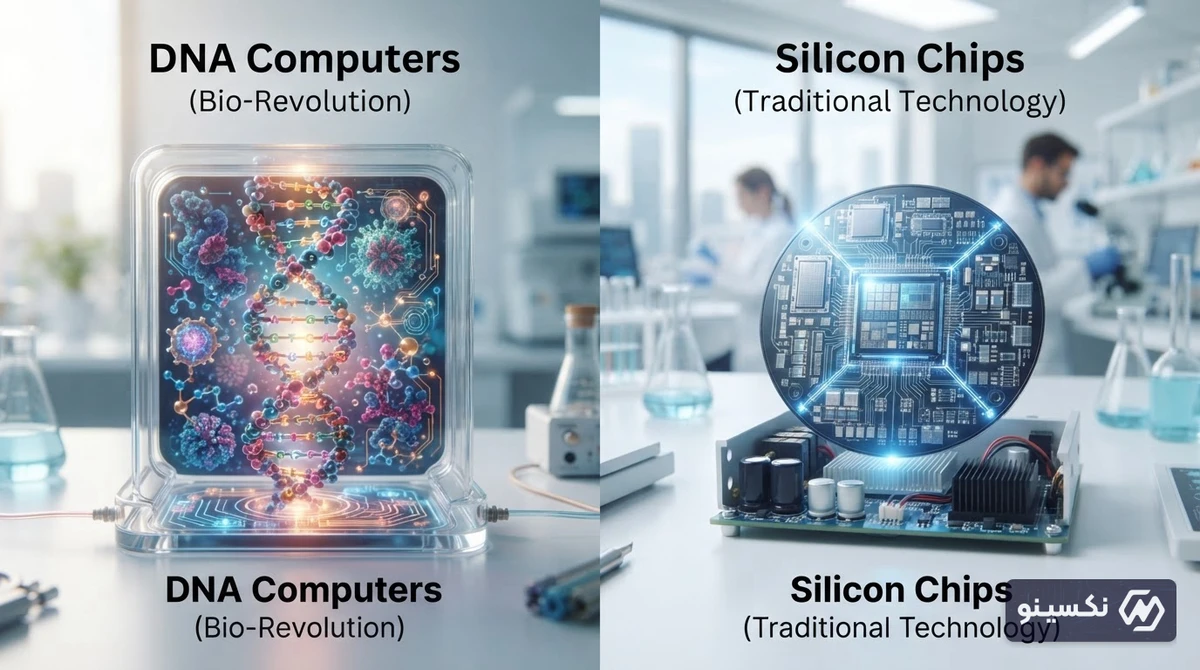
مقایسه جامع: کامپیوترهای DNA در برابر تراشههای سیلیکونی
برای درک بهتر بزرگی این تحول فناوری، جدول زیر تفاوتهای ساختاری میان رایانش کلاسیک سیلیکونی و رایانش بیومولکولی را به نمایش میگذارد:
| شاخص مقایسه | تراشههای سیلیکونی کلاسیک | کامپیوترهای زیستی (DNA) |
|---|---|---|
| واحد داده | بیت (۰ و ۱ با پالس الکتریکی) | نوکلئوتید (A, T, C, G) |
| شیوه محاسبات | ترتیبی و موازی محدود با ترانزیستور | پردازش موازی تریلیونی با واکنشهای بیوشیمیایی |
| چگالی ذخیرهسازی | ترابایت در هر تراشه/دیسک | اگزابایت در تنها چند گرم ماده زیستی |
| مصرف انرژی | بسیار بالا همراه با اتلاف حرارت شدید | بسیار ناچیز در حد واکنشهای بیوشیمیایی طبیعی |
| طول عمر داده | ۵ تا ۲۰ سال (تخریب مغناطیسی یا سیلیکونی) | قرنها تا هزارهها بدون افت کیفیت |
کاربردهای کلیدی رایانش زیستی در دنیای واقعی
ظهور رایانههای مبتنی بر DNA پیامدهایی فراتر از آزمایشگاههای دانشگاهی دارد و میتواند صنایع حیاتی را بازتعریف کند:
- ذخیرهسازی ابرحجیم دادهها: طبق برآوردهای علمی، تمام دادههای تولیدشده توسط بشریت تا به امروز را میتوان درون فضایی به اندازه یک حبه قند از جنس DNA سنتز شده جای داد و برای قرنها بدون مصرف برق ذخیره کرد.
- پزشکی فوقهوشمند درونبدنی: کامپیوترهای نانومقیاس زیستی میتوانند به عنوان گشتهای سلامت در جریان خون حرکت کنند، جهشهای سرطانی را در سطح مولکولی شناسایی کرده و داروی اختصاصی را دقیقاً در سلول هدف آزاد سازند.
- شکستن الگوریتمهای پیچیده و رمزنگاری: به دلیل توانایی تست همزمان تریلیونها مسیر مختلف، این سیستمها در حل مسائل ریاضیاتی فوقپیچیده (مانند مسائل NP-Complete) کاربرد چشمگیری دارند.
- مدلسازی پدیدههای زیستی: طراحی پروتئینهای جدید و کشف داروهای نسل آینده از طریق شبیهسازی بیولوژیکی مستقیم امکانپذیر میشود.
چالشهای اساسی در مسیر تجاریسازی کامپیوترهای ارگانیک
با وجود تمام شگفتیها، تبدیل این فناوری به یک محصول تجاری و عام با چالشهای فنی و اقتصادی مهمی روبهرو است:
- هزینه بالای سنتز و بازخوانی: فرایند ساخت رشتههای اختصاصی DNA (سنتز) و خواندن مجدد آنها (توالییابی یا Sequencing) هنوز گرانقیمت و زمانبر است.
- نرخ خطای بیوشیمیایی: جهشها یا اتصالات غیراختصاصی رشتهها میتواند دقت محاسبات ریاضی را کاهش دهد که نیازمند الگوریتمهای پیشرفته تصحیح خطاست.
- سرعت پایین در محاسبات ساده: در حالی که پردازش موازی این سیستمها بینظیر است، اجرای یک عمل جمع یا تفریق منفرد در آنها بسیار کندتر از سرعت کلاک گیگاهرتزی پردازندههای سیلیکونی است.
چشمانداز آینده؛ همزیستی سیلیکون و زیستشناسی
انتظار نمیرود کامپیوترهای DNA در آینده نزدیک جایگزین گوشیهای هوشمند یا لپتاپهای شخصی شوند؛ بلکه آینده متعلق به «سیستمهای هیبریدی» است. در این ساختار، پردازندههای الکترونیکی وظیفه هدایت و تعامل آنی را بر عهده دارند، در حالی که پردازشهای حجیم و پایگاههای داده عظیم سرد به ساختارهای بیولوژیکی واگذار خواهند شد.
جمعبندی
توسعه کامپیوترهای مبتنی بر DNA گامی انقلابی در تاریخ فناوری محسوب میشود که مرز میان علوم رایانه و زیستشناسی مولکولی را از میان برداشته است. این فناوری با غلبه بر چالشهای بنیادین انرژی و تراکم داده، زیربنای عصر جدیدی از سوپرمحاسبات ارگانیک و ذخیرهسازی دادههای جهان را پایهگذاری میکند.
سؤالات متداول
کامپیوتر DNA چگونه بدون برق محاسبات را انجام میدهد؟
در این کامپیوترها، محاسبات حاصل واکنشهای بیوشیمیایی میان رشتههای اسید نوکلئیک است؛ پیوندها و گسستهای شیمیایی همانند کلیدهای قطع و وصل ترانزیستورها عمل میکنند و نیازی به جریان مداوم الکتریسیته ندارند.
چقدر داده را میتوان درون DNA ذخیره کرد؟
یک گرم DNA تئوریکاً قادر است حدود ۲۱۵ پتابایت (معادل ۲۱۵ میلیون گیگابایت) اطلاعات دیجیتال را به مدت هزاران سال بدون نیاز به انرژی فعال نگهداری کند.
آیا کامپیوترهای زیستی جایگزین کامپیوترهای شخصی و موبایلها میشوند؟
خیر، این فناوری بیشتر برای سوپرمحاسبات فوقموازی، مراکز داده غولپیکر و کاربردهای پزشکی نانو طراحی شده است و به عنوان مکمل تراشههای الکترونیکی در سیستمهای هیبریدی به کار خواهد رفت.
مهمترین مانع تجاریسازی کامپیوترهای DNA چیست؟
هزینه و زمان لازم برای سنتز شیمیایی رشتهها و خوانش مجدد کدهای ژنتیکی (توالییابی) در مقیاس صنعتی از بزرگترین موانع فعلی هستند.