NLP های نکسینو
تمام نیازمندی های شما از یک رسانه هوش مصنوعی
- جدیدترین
کتابخانهی Hugging Face Transformers اکنون امکان بارگذاری و اجرای مستقیم مدلهای فشردهشدهی GGUF را با سرعت بومی llama.cpp روی سختافزارهای محلی فراهم کرده است....
- جدیدترین
پژوهشگران با ارائه یک معماری تفکیکشده فرانتاند-بکاند، امکان اجرای ابزارهای پیشرفته را در مدلهای صوتی بلادرنگ و دوطرفه بدون افزایش تأخیر فراهم کردند....
- جدیدترین
سامانه مایووکس (Myovox) با استفاده از حسگرهای الکترومایوگرافی صورت و تلفیق مدلهای زبانی، توانسته گفتار بیصدا را با کاهش نرخ خطا به ۱۸.۵٪ به متن تبدیل کند....
- جدیدترین
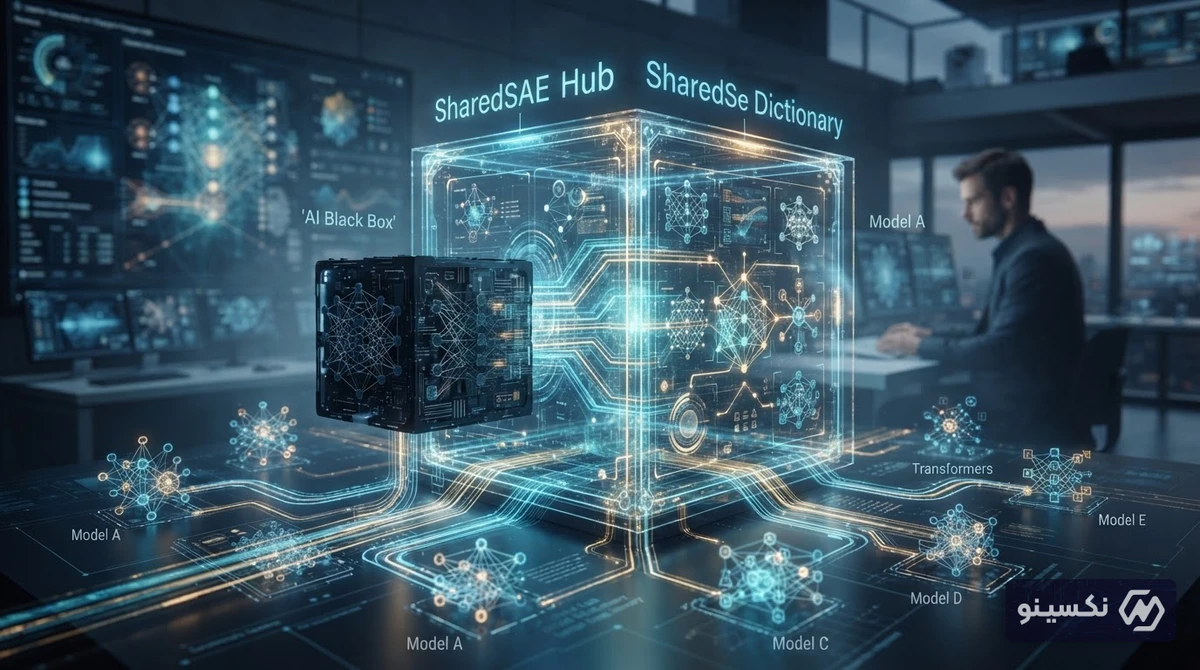
پژوهشگران با معرفی روش SharedSAE امکان رمزگشایی از رفتار مدلهای زبانی گوناگون را با یک دیکشنری ویژگی مشترک و حفظ ۹۶.۶ درصدی دقت ممکن کردند....
- جدیدترین
پژوهشگران روشی نوین توسعه دادهاند که در آن مدلهای زبانی با تکیه بر افت اطمینان آماری درونی خود و بدون نیاز به مجموعهدادههای برچسبخورده، یاد میگیرند در برابر سوالات ناشناخته ابراز بیاطلاعی کنند....
- جدیدترین
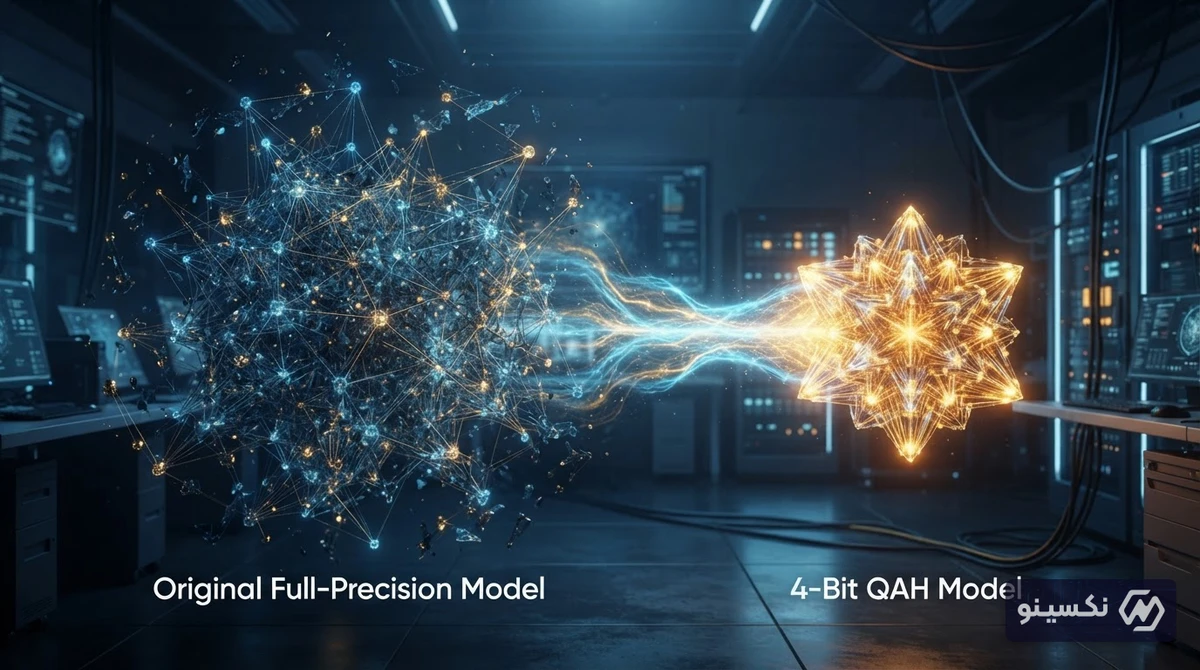
روش جدید Quantization-Aware Healing امکان فشردهسازی مدلهای زبانی بزرگ تا ۴ بیت را فراهم کرده و عملکردی فراتر از مدل اولیه با دقت کامل ارائه میدهد....
- جدیدترین
پژوهشگران با معرفی روش SSR، سرعت مدلهای زبانی استدلالی را بدون نیاز به مدل کمکی و تا ۲۴ درصد افزایش دادهاند....
- جدیدترین
دانشمندان یادگیری ماشین در پژوهشی نوین، روشی ارزانقیمت و بسیار دقیق برای تخمین میزان صحت پاسخهای مدلهای زبانی بزرگ جعبهسیاه ارائه دادهاند که هزینههای توسعه را به شدت کاهش میدهد....
- جدیدترین
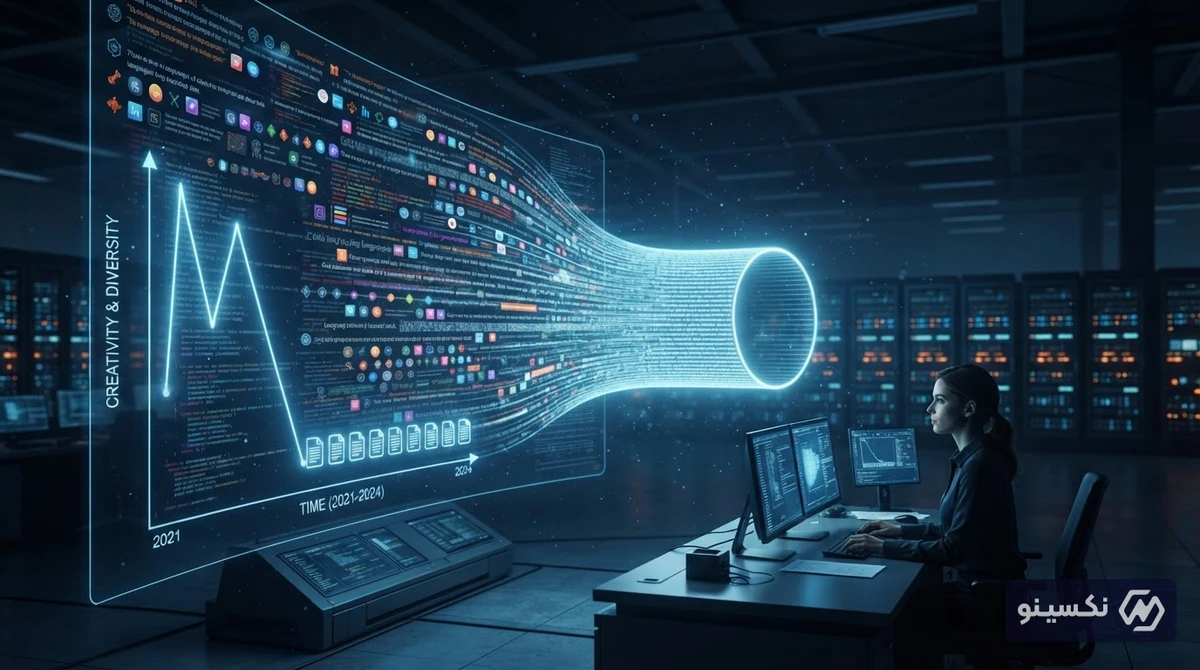
یک پژوهش جدید نشان میدهد که با وجود پیشرفتهای فنی، تنوع و خلاقیت مدلهای بزرگ زبانی (LLM) در سه سال گذشته به شدت کاهش یافته و پاسخهای آنها در حال همگرا شدن است....
- جدیدترین
تحقیقات جدید ثابت میکند که مدلهای زبانی با پارامترهای زیر یک میلیارد میتوانند موجودیتها را در داستانها ردیابی کنند و مدلهای پیشرفتهتر در این زمینه از انسان پیشی گرفتهاند....
- جدیدترین
مدل LFM2.5-DSpark با استفاده از تکنیک رمزگشایی گمانهزنی (Speculative Decoding)، سرعت اجرای مدلهای زبانی را تا ۳.۲ برابر افزایش میدهد و هزینههای پردازشی را بهشدت میکاهد....
دانشمندان یادگیری ماشین در پژوهشی نوین، روشی ارزانقیمت و بسیار دقیق برای تخمین میزان صحت پاسخهای مدلهای زبانی بزرگ جعبهسیاه ارائه دادهاند که هزینههای توسعه را به شدت کاهش میدهد....
مدل LFM2.5-DSpark با استفاده از تکنیک رمزگشایی گمانهزنی (Speculative Decoding)، سرعت اجرای مدلهای زبانی را تا ۳.۲ برابر افزایش میدهد و هزینههای پردازشی را بهشدت میکاهد....
پژوهشگران روشی نوین توسعه دادهاند که در آن مدلهای زبانی با تکیه بر افت اطمینان آماری درونی خود و بدون نیاز به مجموعهدادههای برچسبخورده، یاد میگیرند در برابر سوالات ناشناخته ابراز بیاطلاعی کنند....
تحقیقات جدید ثابت میکند که مدلهای زبانی با پارامترهای زیر یک میلیارد میتوانند موجودیتها را در داستانها ردیابی کنند و مدلهای پیشرفتهتر در این زمینه از انسان پیشی گرفتهاند....
پژوهشگران با معرفی روش SSR، سرعت مدلهای زبانی استدلالی را بدون نیاز به مدل کمکی و تا ۲۴ درصد افزایش دادهاند....
یک پژوهش جدید نشان میدهد که با وجود پیشرفتهای فنی، تنوع و خلاقیت مدلهای بزرگ زبانی (LLM) در سه سال گذشته به شدت کاهش یافته و پاسخهای آنها در حال همگرا شدن است....
پژوهشگران با معرفی روش SharedSAE امکان رمزگشایی از رفتار مدلهای زبانی گوناگون را با یک دیکشنری ویژگی مشترک و حفظ ۹۶.۶ درصدی دقت ممکن کردند....
روش جدید Quantization-Aware Healing امکان فشردهسازی مدلهای زبانی بزرگ تا ۴ بیت را فراهم کرده و عملکردی فراتر از مدل اولیه با دقت کامل ارائه میدهد....
کتابخانهی Hugging Face Transformers اکنون امکان بارگذاری و اجرای مستقیم مدلهای فشردهشدهی GGUF را با سرعت بومی llama.cpp روی سختافزارهای محلی فراهم کرده است....
پژوهشگران با ارائه یک معماری تفکیکشده فرانتاند-بکاند، امکان اجرای ابزارهای پیشرفته را در مدلهای صوتی بلادرنگ و دوطرفه بدون افزایش تأخیر فراهم کردند....
سامانه مایووکس (Myovox) با استفاده از حسگرهای الکترومایوگرافی صورت و تلفیق مدلهای زبانی، توانسته گفتار بیصدا را با کاهش نرخ خطا به ۱۸.۵٪ به متن تبدیل کند....
پژوهشگران با معرفی روش SharedSAE امکان رمزگشایی از رفتار مدلهای زبانی گوناگون را با یک دیکشنری ویژگی مشترک و حفظ ۹۶.۶ درصدی دقت ممکن کردند....
پژوهشگران روشی نوین توسعه دادهاند که در آن مدلهای زبانی با تکیه بر افت اطمینان آماری درونی خود و بدون نیاز به مجموعهدادههای برچسبخورده، یاد میگیرند در برابر سوالات ناشناخته ابراز بیاطلاعی کنند....
روش جدید Quantization-Aware Healing امکان فشردهسازی مدلهای زبانی بزرگ تا ۴ بیت را فراهم کرده و عملکردی فراتر از مدل اولیه با دقت کامل ارائه میدهد....
پژوهشگران با معرفی روش SSR، سرعت مدلهای زبانی استدلالی را بدون نیاز به مدل کمکی و تا ۲۴ درصد افزایش دادهاند....
دانشمندان یادگیری ماشین در پژوهشی نوین، روشی ارزانقیمت و بسیار دقیق برای تخمین میزان صحت پاسخهای مدلهای زبانی بزرگ جعبهسیاه ارائه دادهاند که هزینههای توسعه را به شدت کاهش میدهد....
یک پژوهش جدید نشان میدهد که با وجود پیشرفتهای فنی، تنوع و خلاقیت مدلهای بزرگ زبانی (LLM) در سه سال گذشته به شدت کاهش یافته و پاسخهای آنها در حال همگرا شدن است....
تحقیقات جدید ثابت میکند که مدلهای زبانی با پارامترهای زیر یک میلیارد میتوانند موجودیتها را در داستانها ردیابی کنند و مدلهای پیشرفتهتر در این زمینه از انسان پیشی گرفتهاند....
مدل LFM2.5-DSpark با استفاده از تکنیک رمزگشایی گمانهزنی (Speculative Decoding)، سرعت اجرای مدلهای زبانی را تا ۳.۲ برابر افزایش میدهد و هزینههای پردازشی را بهشدت میکاهد....
درخواست مشاوره
برای دریافت مشاوره تخصصی و راهنماییهای دقیق، فرم زیر را پر کنید و تیم ما در سریعترین زمان ممکن با شما تماس خواهد گرفت.
