تصور کنید بتوانید بدون تولید کوچکترین صدایی و صرفاً با حرکت نامحسوس عضلات فک و صورت، جملات کاملی را به متن تبدیل کنید یا با دستیارهای صوتی صحبت کنید. پژوهش جدیدی با معرفی سامانه «مایووکس» (Myovox)، این سناریوی علمیتخیلی را گامی بزرگ به واقعیت نزدیک کرده است. این فناوری با استفاده از حسگرهای الکترومایوگرافی سطحی و ترکیب آن با مدلهای زبانی پیشرفته، توانسته نرخ خطای تبدیل حرکات صورت به کلمات را به طرز چشمگیری کاهش دهد.
انقلاب در رابطهای گفتار صامت؛ از عضله تا کلمه
فناوری گفتار صامت (Silent Speech Interface یا SSI) سالهاست که بهعنوان یکی از جذابترین حوزههای بینرشتهای میان هوش مصنوعی و بیومکانیک شناخته میشود. سیستمهای مرسوم تشخیص صدا متکی بر امواج صوتی تولیدشده از حنجره و تارهای صوتی هستند؛ اما در محیطهای بسیار پر سر و صدا، شرایط نیازمند به برقراری ارتباط محرمانه یا برای بیمارانی که توانایی صوتی خود را بر اثر بیماریهایی مانند ALS، جراحی لارنژکتومی یا سکته از دست دادهاند، این سیستمها عملاً بیفایدهاند.
سیستم Myovox (ترکیبی از دو واژه Myo به معنای عضله و Vox به معنای صدا) رویکردی نوین را پیش گرفته است. این سامانه با رهگیری پتانسیلهای الکتریکی حاصل از انقباض عضلات صورت از طریق ۳۱ کانال الکترومایوگرافی سطحی (sEMG)، سیگنالهای نامحسوس حرکتی را به متن باز و دقیق انگلیسی ترجمه میکند.
جهش فنی مایووکس؛ کاهش نرخ خطا از ۵۱٪ به ۱۸.۵٪
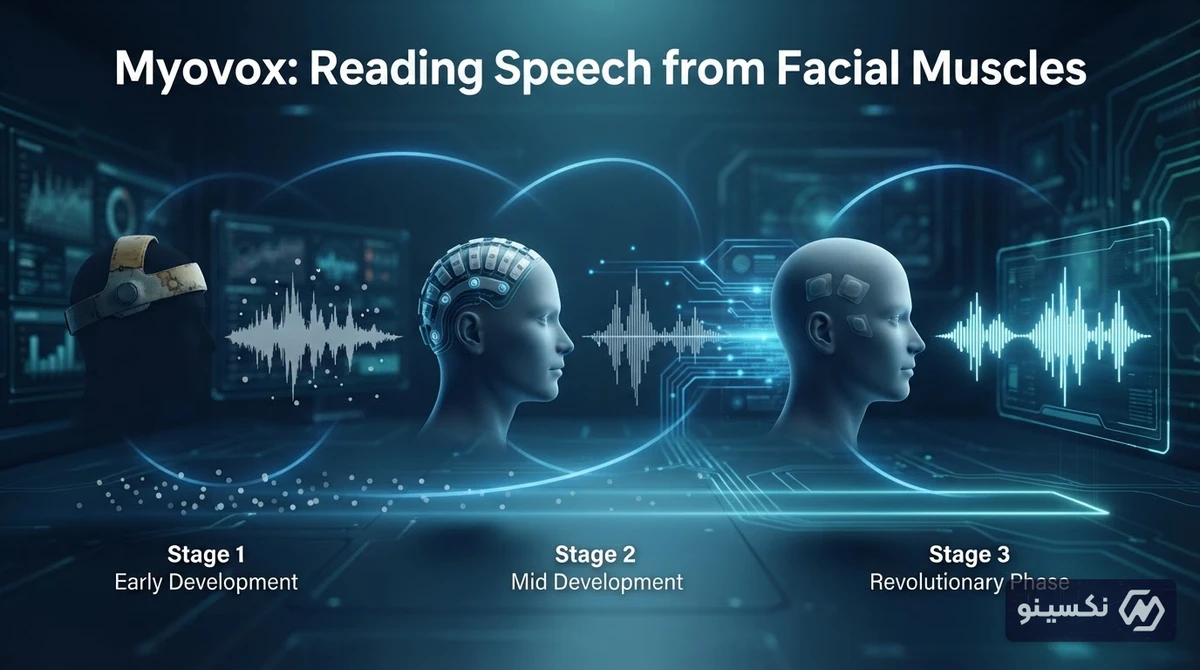
پیش از این، بهترین سیستمهای رمزگشایی متن از روی دیتاست مرجع emg2speech دارای نرخ خطای کلمه (WER) معادل ۵۱.۱۷ درصد بودند؛ آماری که برای استفادههای روزمره و تجاری بسیار ناکارآمد بهشمار میرفت. معماری جدید مایووکس طی سه مرحله مهندسی مجزا، این خطا را تا رقم کمسابقه ۱۸.۵۳ درصد کاهش داده است:
۱. بازسازی دقیق خط مبنا و استانداردسازی رمزگشایی
در گام اول، محقق این پروژه متغیرهای پنهان و مفقود در رمزگشایی واژگان باز (Open-Vocabulary) را شناسایی و بازتولید کرد. این اصلاح پایهای باعث شد نرخ خطای کلمات در مدل پایه اولیه بدون هیچ تغییر ساختاری، مستقیماً به ۴۰.۶۳ درصد کاهش پیدا کند و نرخ خطای واجها (PER) نیز استاندارد شود.
۲. ترکیب معماری کانفورمر (Conformer) و تقطیر دانش صوتی
گام کلیدی دوم مایووکس، جایگزینی رمزگذارهای سنتی با یک رمزگذار دوطرفه Conformer بود. این مدل با روش تقطیر بینوجهی (Cross-Modal Distillation) آموزش داده شده است؛ به این معنا که سیگنالهای عضلانی مستقیماً از روی لایه نهم مدل صوتی قدرتمند WavLM-Large یاد میگیرند که چگونه ویژگیهای پنهان آکوستیک را بازسازی کنند. این نوآوری بهتنهایی نرخ خطا را تا ۲۶.۱۴ درصد پایین آورد.
۳. بازرتبهبندی با مدلهای زبانی بزرگ ۷ میلیاردی (QLoRA)
در نهایت، خروجیهای چندگانه چند مدل آکوستیک با یکدیگر ترکیب شده و یک مدل زبانی ۷ میلیارد پارامتری بهینهسازیشده با تکنیک QLoRA، محتملترین و منطقیترین جملات را بازرتبهبندی (Reranking) میکند. حاصل این فرآیند ثبت نرخ خطای نهایی ۱۸.۵۳ درصد است که بهترین رکورد ثبتشده روی این دیتاست محسوب میشود.
مقایسه گامهای توسعه مایووکس در کاهش خطای گفتار
جدول زیر مسیر بهینهسازی و افت چشمگیر نرخ خطای مدل را در مراحل مختلف نشان میدهد:
| مرحله توسعه | نرخ خطای کلمه (WER) | نرخ خطای واج (PER) | تکنولوژی محوری |
|---|---|---|---|
| مدل مرجع پیشین | ۵۱.۱۷٪ | ۳۹.۸٪ | شبکههای بازگشتی سنتی |
| اصلاح تنظیمات رمزگشایی | ۴۰.۶۳٪ | ۳۹.۰۲٪ | استانداردسازی بازتولید |
| ادغام Conformer + WavLM | ۲۶.۱۴٪ | ۲۲.۳۴٪ | تقطیر دانش بینوجهی |
| همافزایی مدلها + مدل زبانی ۷B | ۱۸.۵۳٪ | ۲۰.۹٪ | استنتاج زبانی ترکیبی (QLoRA) |
سقف شیشهای بیومکانیک؛ چرا مدل به خطای صفر نمیرسد؟
یکی از نکات تحلیلی و صادقانه در پژوهش مایووکس، کشف یک «نتیجه منفی» اما بنیادین است. طبق یافتههای این بررسی، حتی اگر از بزرگترین مدلهای زبانی دنیا برای اصلاح خروجی استفاده شود، نرخ خطا از حدود ۱۸.۵ درصد کمتر نمیشود. دلیل این موضوع به مدلهای زبانی مربوط نیست؛ بلکه محدودیت اصلی در سیگنالهای خام الکترومایوگرافی نهفته است.
سیگنالهای الکتریکی عضلات صورت در مواردی واجهای بسیار مشابه (مثل صدای «پ» و «ب») را به شکل کاملاً یکسان ارسال میکنند؛ بنابراین کلمه صحیح اصلاً در ماتریس احتمالات آکوستیک اولیه وجود ندارد که مدل زبانی بتواند آن را پیدا کند.
تأثیر این دستاورد بر بازار گجتهای پوشیدنی و سلامت
پیشرفت مایووکس اثرات فراتر از مرزهای آکادمیک دارد. غولهای فناوری نظیر مِتا (Meta) و اپل سرمایهگذاریهای سنگینی روی رابطهای عصبی و حرکتی موسوم به EMG برای هدستهای واقعیت ترکیبی و ساعتهای هوشمند انجام دادهاند. با ارتقای الگوریتمهای ترجمه پالسهای صورت:
- گجتهای پوشیدنی نامرئی: امکان تعامل با عینکهای هوشمند بدون جلب توجه اطرافیان و با زمزمههای بیصدا فراهم میشود.
- فناوریهای کمکی پزشکی: بازگشت توانایی گفتار فوری و طبیعی به بیمارانی که تارهای صوتی آسیبدیده دارند اما عضلات صورتشان کار میکند.
- کاربردهای نظامی و امنیتی: ارسال پیامهای رمزگذاریشده بدون باز کردن دهان یا انتشار امواج صوتی در عملیات حساس.
جمعبندی
پروژه Myovox نقطه عطفی در توسعه رابطهای انسان و کامپیوتر صامت به شمار میرود. اگرچه وجود نویزهای بیولوژیکی و محدودیت وضوح الکترودهای سطحی چالشهایی بنیادین هستند، اما ادغام بینایی حرکتی عضلات با غنای شناختی مدلهای زبانی بزرگ، ما را به روزی نزدیک میکند که برای تایپ، مکالمه و کنترل دستگاههای دیجیتال، حتی نیازی به تکان دادن تارهای صوتی خود نداشته باشیم.
سؤالات متداول
سیستم مایووکس (Myovox) دقیقاً چگونه کار میکند؟
این سامانه با نصب ۳۱ حسگر سطحی روی عضلات صورت، سیگنالهای الکتریکی انقباض عضلات هنگام حرف زدن را ثبت کرده و از طریق هوش مصنوعی Conformer و مدلهای زبانی، آن پالسها را به متن انگلیسی تبدیل میکند.
آیا این سیستم میتواند ذهن افراد را بخواند؟
خیر؛ مایووکس ذهنخوان نیست. این سیستم فقط پالسهای فیزیکی ناشی از تلاش عضلات صورت برای حرف زدن (حتی صامت و بدون تولید صوت) را رهگیری و ترجمه میکند.
میزان دقت مایووکس در مقایسه با سیستمهای گذشته چقدر است؟
مایووکس توانسته نرخ خطای کلمات (WER) را از ۵۱.۱۷ درصد در روشهای پیشین به ۱۸.۵۳ درصد کاهش دهد که ارتقایی چشمگیر در پردازش دادههای EMG صورت است.
مهمترین کاربردهای تجاری این فناوری در آینده چیست؟
توسعه عینکهای هوشمند با ورودی صامت، فناوریهای کمکی برای افراد لال یا فاقد حنجره، و کاربردهای ارتباطی امنیتی و نظامی در شرایط نویزی.