در حالی که رقابت برای توسعه مدلهای پیشرفتهتر هوش مصنوعی به اوج خود رسیده است، دو بازیگر اصلی این عرصه یعنی OpenAI و Anthropic استراتژی جدیدی را برای تأمین زیرساختهای پردازشی در پیش گرفتهاند. گزارشهای اخیر نشان میدهد که این شرکتها به جای اتکای صرف به مگاپروژههای عظیم و زمانبر، اکنون در پی انعقاد قراردادهای متعدد با مراکز داده کوچکتر هستند تا ظرفیت محاسباتی خود را با سرعت بیشتری افزایش دهند.
چرخش استراتژیک در زیرساخت هوش مصنوعی؛ چرا دیتاسنترهای کوچک؟
مسابقه ساخت مدلهای بزرگ زبانی (LLM) وارد فاز جدیدی شده است؛ فازی که در آن دسترسی سریع به توان محاسباتی (Compute Capacity) ارزش بیشتری نسبت به برنامههای بلندمدت دارد. بر اساس گزارشهای منتشرشده، شرکتهای OpenAI و Anthropic در حال مذاکره و ثبت قرارداد با ارائهدهندگان مراکز داده در ابعاد کوچک و متوسط هستند.
تا پیش از این، تمرکز اصلی بر ساخت تأسیسات عظیم چندهزار مگاواتی و همکاریهای کلان با غولهایی مانند مایکروسافت، آمازون و گوگل بود. با این حال، نیاز فوری به استقرار سرورهای جدید مجهز به پردازندههای گرافیکی انویدیا، این دو استارتاپ پیشرو را به سمت توزیع زیرساختها سوق داده است.
چالش مگاپروژهها: بحران شبکه برق و زمان تحویل طولانی
ساخت مراکز داده فوقعظیم (Hyperscale) با موانع ساختاری متعددی روبهرو است که مهمترین آنها عبارتاند از:
- کمبود و تأخیر در اتصال به شبکه برق: پروژههای عظیم به صدها مگاوات برق نیاز دارند که دریافت مجوز و اتصال آنها به شبکه انتقال انرژی ممکن است سالها طول بکشد.
- محدودیتهای زنجیره تأمین: تأمین تجهیزات خنککننده پیشرفته و ترانسفورماتورهای قدرت در مقیاسهای غولپیکر با صفهای انتظار طولانی مواجه است.
- فشار زمان در استقرار مدلها: برای عرضه نسخههای جدیدتر مانند GPT-5 یا نسلهای بعدی Claude، شرکتها نمیتوانند تا پایان ساخت ابرمراکز در سالهای ۲۰۲۶ یا ۲۰۲۷ منتظر بمانند.
دیتاسنترهای کوچکتر که ظرفیتهای چند مگاواتی یا دهها مگاواتی دارند، معمولاً از پیش به زیرساختهای برق و خنککننده مجهز هستند و میتوانند ظرف چند ماه میزبان هزاران تراشه هوش مصنوعی شوند.
مقایسه استراتژی دیتاسنترهای مگاسایز و خوشهای
برای درک بهتر تفاوت این دو رویکرد، جدول زیر مزایا و محدودیتهای هر مدل را نشان میدهد:
| شاخص | دیتاسنترهای کلان (Hyperscale) | دیتاسنترهای کوچک و ماژولار |
|---|---|---|
| زمان راهاندازی | ۲ تا ۴ سال | چند ماه تا ۱ سال |
| دسترسی به انرژی | نیازمند توسعه خطوط انتقال اختصاصی | استفاده از ظرفیتهای آزاد محلی |
| کاربرد بهینهتر | آموزش اولیه مدلهای فوقسنگین | استنتاج (Inference) و آموزشهای موازی |
| هزینه اولیه | بسیار سنگین (میلیارد دلاری) | انعطافپذیر و توزیعشده |
فرصت کمنظیر برای ارائهدهندگان مستقل ابری و زیرساخت
این تغییر جهت، اکوسیستم جدیدی را فعال کرده است. شرکتهای زیرساختی کوچکتر، استارتاپهای انرژی پاک و ارائهدهندگان خدمات هممکانی (Colocation) اکنون مشتریانی پیدا کردهاند که حاضرند مبالغ بالایی برای اجاره کوتاهمدت یا میانمدت فضای سرور بپردازند.
«سرعت استقرار به مهمترین عامل تمایز در نبرد هوش مصنوعی تبدیل شده است؛ هر شرکتی که بتواند تراشههای بیشتری را زودتر روشن کند، رهبری بازار را به دست میگیرد.»
این تحول نهتنها انحصار مراکز داده غولپیکر را تعدیل میکند، بلکه به توزیع جغرافیایی توان پردازشی و کاهش ریسک تمرکز انرژی در یک منطقه خاص نیز کمک خواهد کرد.
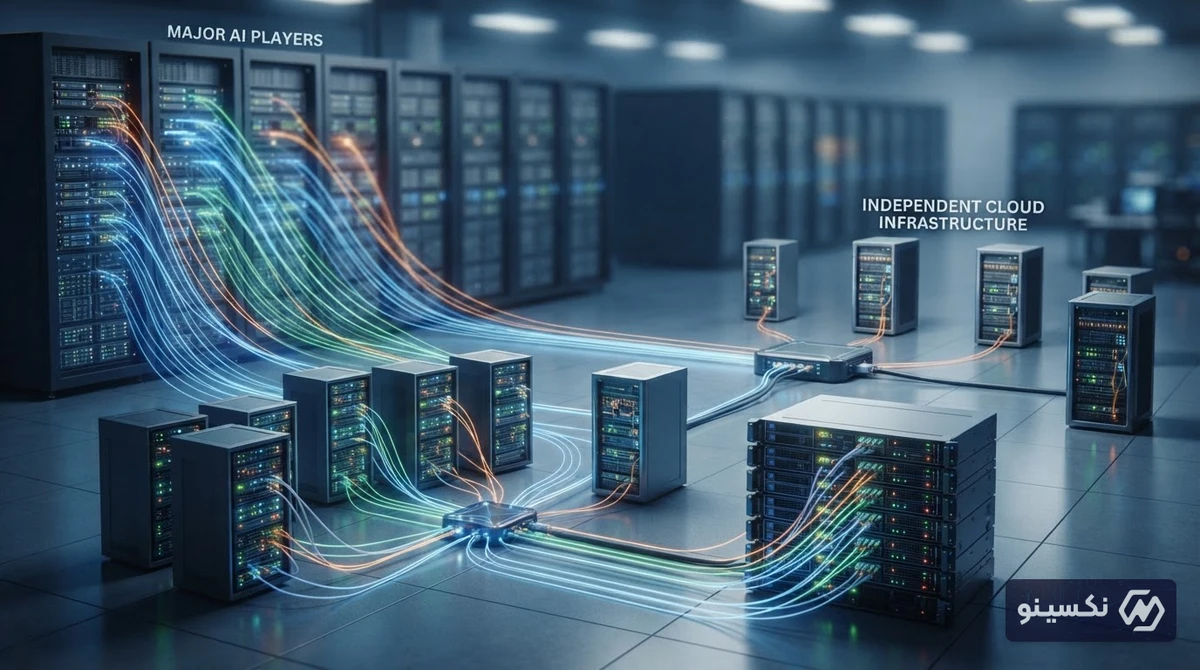
پیامدها برای آینده محصولات OpenAI و Anthropic
تأمین ظرفیت از دیتاسنترهای کوچک به این دو غول هوش مصنوعی اجازه میدهد بارهای کاری استنتاج (Inference) را—که برای پاسخدهی به کاربران عمومی در ChatGPT و Claude استفاده میشود—از بارهای کاری آموزش (Training) جدا کنند. این تفکیک هوشمندانه، بازدهی عملیاتی را افزایش داده و هزینه پردازش درخواستهای کاربران را بهینهتر میکند.
جمعبندی
تغییر مسیر OpenAI و Anthropic به سمت دیتاسنترهای کوچکتر، پاسخی هوشمندانه به محدودیتهای شبکه برق و رقابت فشرده زمانی در عرضه فناوریهای جدید است. این استراتژی نشان میدهد که در میدان هوش مصنوعی، چابکی و سرعت عمل بر ساخت پروژههای پرزرقوبرق اما طولانیمدت برتری دارد و دسترسی سریع به انرژی و توان محاسباتی تعیینکننده برنده نهایی این رقابت خواهد بود.
سؤالات متداول
چرا OpenAI و Anthropic به سراغ دیتاسنترهای کوچکتر رفتهاند؟
دیتاسنترهای کوچکتر زیرساختهای برق و خنککننده آماده دارند و میتوانند در چند ماه فعال شوند، در حالی که ساخت مراکز داده غولپیکر چندین سال زمان میبرد.
آیا این تغییر استراتژی به معنای توقف پروژههای بزرگ دیتاسنتر است؟
خیر؛ پروژههای عظیم چندمیلیارد دلاری همچنان برای آموزش مدلهای نسل بعد ادامه دارند، اما دیتاسنترهای کوچک به عنوان راهحل کوتاهمدت و موازی برای پاسخ به تقاضای فعلی به کار گرفته میشوند.
بزرگترین مانع بر سر راه توسعه مراکز داده بزرگ چیست؟
محدودیتهای شبکه انتقال برق، فرآیند طولانی اخذ مجوزهای محیطزیستی و کمبود تجهیزات اختصاصی شبکه و خنککننده اصلیترین موانع هستند.
چه تفاوتی میان بار کاری آموزش و استنتاج وجود دارد؟
آموزش نیازمند هزاران تراشه متصل و یکپارچه در یک مکان واحد است، اما استنتاج (پاسخ به سوالات کاربران) میتواند در مراکز داده کوچکتر و پراکنده جغرافیایی انجام شود.