هوش مصنوعی های نکسینو
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین
- جدیدترین

رقابت هوش مصنوعی در سالهای اولیه بیشتر با نام مدلهای بزرگ و Benchmarkهای جدید شناخته میشد، اما دادههای تازه Hugging Face نشان میدهد در سال ۲۰۲۶ سؤال مهمتری مطرح شده است: کدام مدلها واقعاً وارد ابزارها و جریان کاری توسعهدهندگان میشوند؟ گزارش State of Open Models: Summer 2026 تصویری متفاوت از بازار ارائه میدهد. از یک طرف، آزمایشگاههای چینی مدلهای Open-Weight را به مقیاس چندصد میلیارد و حتی چندتریلیون پارامتری رساندهاند؛ از طرف دیگر، بخش بزرگی از استفاده واقعی همچنان مربوط به مدلهای کوچک و قدیمیتری است که سالهاست در نرمافزارها و Pipelineهای مختلف استفاده میشوند. در میان این دو جریان، Qwen توانسته به یکی از مهمترین پایههای توسعه مدلهای جدید تبدیل شود و همزمان AI Agentها نیز به کاربران جدید زیرساختهای Hugging Face تبدیل شدهاند. اکوسیستم Open Model با چه سرعتی رشد کرده است؟ Hugging Face میگوید از ابتدای ۲۰۲۶ تا پایان ژوئیه، تعداد Repositoryهای عمومی مدل از ۲.۴۳ میلیون به ۲.۹۶ میلیون رسیده است. تعداد Datasetها نیز از ۷۱۱ هزار به حدود یک میلیون و Spaces از یک میلیون به ۱.۴۴ میلیون افزایش یافته است. اما این رشد یک نکته مهم را پنهان میکند: عرضه مدل بسیار بیشتر از استفاده واقعی آنهاست. حدود ۸۵.۶٪ مدلها در Hub کمتر از ۲۰۰ دانلود مادامالعمر دارند و تنها ۱.۵٪ Repositoryها تقریباً ۹۹.۲٪ کل دانلودها را ایجاد کردهاند. بنابراین انتشار یک مدل جدید لزوماً به معنای Adoption گسترده نیست. این تفاوت برای تحلیل صنعت AI اهمیت زیادی دارد. بازار Open Model فقط مسابقهای برای انتشار مدل جدید نیست؛ برنده واقعی ممکن است مدلی باشد که سالها در پروژهها، اپلیکیشنها و زیرساختهای توسعهدهندگان باقی بماند. چین چگونه به مرز مدلهای Open-Weight رسیده است؟ یکی از مهمترین یافتههای Hugging Face، تغییر موازنه جغرافیایی مدلهای باز است. در تقریباً تمام ماههای ۲۰۲۶، بزرگترین مدل Open منتشرشده از سوی یک آزمایشگاه چینی از مدلهای آمریکایی همان ماه بزرگتر بوده است. سقف مدلهای چینی در این دوره بین حدود ۷۵۴ میلیارد تا ۲.۷۸ تریلیون پارامتر حرکت کرده، در حالی که مدلهای آمریکایی در پنج ماه از هفت ماه زیر ۱۳۰ میلیارد پارامتر باقی ماندهاند. البته تعداد پارامتر بهتنهایی معیار کیفیت نیست. اهمیت این اتفاق بیشتر در تغییر استراتژی شرکتهاست. شرکتهایی مانند Moonshot، MiniMax، Xiaomi و Z.ai مستقیماً سراغ مدلهای بسیار بزرگ رفتهاند، در حالی که Alibaba و Tencent خانوادههایی از مدلهای کوچک تا بسیار بزرگ ارائه میکنند. این تفاوت دو استراتژی را نشان میدهد: یک شرکت میتواند تمام تمرکز خود را روی Frontier Model و Benchmark بگذارد، یا خانوادهای گسترده بسازد که توسعهدهنده برای هر اندازه سختافزار بتواند در همان اکوسیستم باقی بماند. محبوبیت با استفاده واقعی یکی نیست یکی از جالبترین بخشهای گزارش، مقایسه Likes و Downloads است. Hugging Face، ۲۵ Repository برتر از نظر Likes و ۲۵ مدل برتر از نظر دانلود طی سال ۲۰۲۶ را مقایسه کرده و فقط یک مدل در هر دو فهرست قرار گرفته است. حتی هیچ مدلی که در ۲۰۲۶ منتشر شده، وارد ۲۵ مدل برتر دانلود نشده و ۱۳ مدل این فهرست به سال ۲۰۲۲ برمیگردند. این تفاوت نشان میدهد Like بیشتر نماینده توجه و هیجان جامعه است، اما Download میتواند نشان دهد چه مدلی واقعاً داخل Pipelineها و محصولات قرار گرفته است. مدل Frontier جدید ممکن است هزاران Like بگیرد، اما یک Embedding Model قدیمی میتواند روزانه میلیونها بار در زیرساختهای واقعی استفاده شود. به همین دلیل، ارزیابی وضعیت صنعت AI تنها براساس ترندهای شبکههای اجتماعی یا رتبه Benchmark میتواند تصویر ناقصی ایجاد کند. Qwen چگونه به مدل پایه جامعه Open Model تبدیل شد؟ شاید مهمترین نتیجه گزارش برای Alibaba این باشد که Hugging Face، Qwen را یکی از بزرگترین پایههای اکوسیستم مدلهای باز میداند. براساس دادههای Hub، بیش از ۱۵۱ هزار مدل مشتقشده بر پایه Qwen ساخته شده است؛ رقمی حدود ۲.۶ برابر کل ردپای مدلهای Meta و ۴.۷ برابر Repositoryهایی که مشخصاً از Llama مشتق شدهاند. Google نیز با بیش از ۸۲ هزار مدل مشتقشده در جایگاه بعدی قرار دارد. طبق گزارش، در هفت ماه نخست ۲۰۲۶ روزانه تقریباً ۱۸۰ تا ۲۱۰ Repository جدید مبتنی بر Qwen ایجاد شده است. این یعنی موفقیت Qwen دیگر فقط نتیجه یک عرضه پرسروصدا نیست، بلکه توسعهدهندگان بهصورت مستمر آن را برای Fine-Tuning، Quantization و ساخت مدلهای تخصصی انتخاب میکنند. یکی از دلایل این رشد، تنوع خانواده Qwen است. Alibaba از مدلهای کوچک قابل اجرا روی دستگاههای شخصی تا مدل عظیم Qwen3.8-Max را در یک خانواده ارائه میکند. توسعهدهنده میتواند بدون تغییر کامل اکوسیستم، مدل متناسب با سختافزار و پروژه خود را انتخاب کند. چرا مدلهای کوچک هنوز لایه عملی AI هستند؟ مدلهای چندتریلیون پارامتری بخش عمده اخبار را به خود اختصاص میدهند، اما استفاده واقعی تصویر متفاوتی دارد. در میان مدلهایی که تعداد پارامتر خود را اعلام کردهاند، مدلهای زیر یک میلیارد پارامتر ۸۳٪ کل دانلودهای تاریخی را تشکیل میدهند، در حالی که سهم مدلهای بالای ۱۰۰ میلیارد پارامتر تنها حدود یک درصد است. حتی اگر فقط دانلودهای ۲۰۲۶ را بررسی کنیم، مدلهای بالای ۷۰ میلیارد پارامتر حدود ۳٪ حجم را تشکیل میدهند. دلیل ساده است: مدل کوچک روی سختافزاری اجرا میشود که توسعهدهنده واقعاً در اختیار دارد. هزینه استقرار پایینتر است، Latency کمتر میشود و برای بسیاری از وظایف تخصصی نیازی به یک Frontier Model عظیم وجود ندارد. بنابراین «مدل بزرگتر» لزوماً به معنی «مدل پرکاربردتر» نیست. Local AI چگونه مدلهای بزرگ را به سختافزار معمولی نزدیک میکند؟ در کنار مدلهای کوچک، اکوسیستم Quantization و Local Inference نیز رشد سریعی داشته است. Hugging Face بهطور ویژه به نقش llama.cpp و فرمت GGUF اشاره میکند؛ ابزارهایی که اجرای نسخههای فشردهشده مدلهای بزرگ را روی سختافزارهای مصرفی یا مجموعهای از چند سیستم امکانپذیر کردهاند. گزارش میگوید Repositoryهایی که از GGUF استفاده میکنند در این بازه ۴۶۴٪ رشد کردهاند؛ بسیار سریعتر از رشد کلی Repositoryهای مدل. Qwen نیز حدود ۳۹.۶ میلیون دانلود ماهانه GGUF داشته، در مقایسه با ۲۰.۸ میلیون برای Gemma و ۷.۵ میلیون برای Llama. این روند را در مدلهایی مانند DeepSeek V4 Flash نیز میتوان دید؛ جایی که Quantization و ابزارهای Community فاصله میان مدل Frontier و سختافزار در اختیار کاربران را کمتر میکنند. Agentها؛ کاربران جدید Hugging Face Hub یکی از تازهترین تغییرات اکوسیستم این است که دیگر همه کاربران Hub انسان نیستند. Hugging Face از
...
موسیقی و صدا با هوش مصنوعی، تنها در چند دقیقه میتوانید موسیقی بسازید، صداگذاری کنید، و حتی یک خواننده شوید! ولی کدام ابزار ها از زبان فارسی پشتیبانی می کنند؟ کدام یک برای ما ایرانی ها که دسترسی به پرداخت بین المللی نداریم پلن های رایگان قدرتمندی دارند؟ در این مقاله در نکسینو همراه ما باشید تا 7 ابزار خارقالعاده را معرفی کنیم که انقلابی در ساخت موسیقی، افکتهای صوتی، صداگذاری و حتی خوانندگی ایجاد کردهاند و تمامی قابلیت ها و مزایای آنها را بیان کنیم. نام ابزار نوع اصلی ابزار قابلیت تولید وکال/آواز پشتیبانی از زبان فارسی (برای وکال) قابلیتهای رایگان (نسخه Free/Trial) Suno AI تولید آهنگ و آواز با هوش مصنوعی (Text-to-Song) بله (هوش مصنوعی آواز میخواند) بله تعداد محدودی آهنگ در روز با متن و سبک دلخواه در استفاده رایگان. Voicemod AI تغییر صدا در زمان واقعی (Real-time Voice Changer) بله (صدای کاربر را تغییر میدهد) بله (صدای فارسی شما را تغییر میدهد) دسترسی به تعداد محدودی صدای از پیش تعیین شده، دارای تبلیغات. ElevenLabs تبدیل متن به گفتار (TTS) و کلونینگ صدا بله (گفتار طبیعی) بله 10,000 کاراکتر در ماه، دسترسی به صداهای پایه، بدون استفاده تجاری. Uberduck تبدیل متن به گفتار، آواز و رپ، کلونینگ صدا بله (گفتار، آواز و رپ) بله 300 کردیت رندر در ماه، دسترسی به صداهای عمومی، بدون استفاده تجاری. Murf AI تبدیل متن به گفتار (TTS) بله (گفتار طبیعی) خیر 10 دقیقه تولید و 10 دقیقه رونویسی، بدون امکان دانلود خروجی، بدون مجوز تجاری. Soundraw تولید موسیقی ابزاری با هوش مصنوعی خیر (فقط موسیقی ابزاری) خیر تولید نامحدود آهنگ، اما دانلود محدود و بدون مجوز تجاری (فقط برای تست). Beatoven.ai تولید موسیقی ابزاری با هوش مصنوعی خیر (فقط موسیقی ابزاری) خیر تولید نامحدود آهنگ، اما فقط پیشنمایش، بدون امکان دانلود. Suno AI اولین ابزاری که به عنوان یکی از سایت های ساخت آهنگ با هوش مصنوعی رایگان به شخصه استفاده کرده ام، Suno است که جزو بهترین ابزار های ساخت آهنگ با هوش مصنوعی فارسی به شمار می رود. این ابزار در واقع پلتفرم تولید موسیقی با هوش مصنوعی است که از طریق پرامپت های متنی شما (text-to-music) آهنگهای کامل شامل وکال، ملودی، تنظیم و ساختار آهنگ را خلق می کند. من خودم برای ساخت آهنگ تبریک تولد از این پلتفرم استفاده کرده ام و باید بگویم از صدای فارسی به خوبی پشتیبانی می کند. 🥳 فقط باید دقت داشته باشید که اگر تلفظ به خوبی صورت نگرفت از اعراب گذاری (فتحه و کسره و …) در پرامپت استفاده کنید. همچنین اگر خروجی مناسبی از این ابزار ساخت صدا با هوش مصنوعی دریافت نکردید مجددا پرامپت دیگری بنویسید (دقت کنید که تا 10 آهنگ در روز می توانید تولید کنید). Suno AI در دسامبر ۲۰۲۳ راهاندازی شد و نسخه ۴.۵ آن در مارس ۲۰۲۵ منتشر شده که کیفیت وکال و ساختار آهنگها را به شدت ارتقا داده است و یکی از بهترین ابزار های تولید آهنگ با AI است. برای ساخت آهنگ هم کافی است که سبک، موضوع یا متن دلخواه را بنویسید؛ Suno در چند ثانیه آهنگ کامل با تنظیم، ملودی و وکال تولید میکند. ویژگی های SUNO: مزایا: معایب: پلن های اشتراکی: طرح اشتراک قیمت (ماهانه) اعتبار نوع استفاده Basic ۰ دلار ۵۰ / روز (۱۰ آهنگ روزانه) بدون امکان استفاده تجاری Pro ۸–۱۰ دلار (ماهانه) / ۶٫۴–۸ دلار (سالیانه) ۲٬۵۰۰ / ماه استفاده تجاری مجاز Premier ۲۴–۳۰ دلار (ماهانه) / ۱۹٫۲–۲۴ دلار (سالیانه) ۱۰٬۰۰۰ / ماه مجوز تجاری کامل دیدن اطلاعات بیشتر و استفاده از Suno AI: Voicemod AI اگر دنبال ابزاری هستید که صدای خودتان را به صدای خواننده های معروف تبدیل کنید این هوش مصنوعی برای شما ساخته شده! همچنین با این ابزار می توانید صدای دیگر خوانندگان را به جای خواننده های دیگر قرار دهید. همچنین می توانید صدای خودتان را با افکتهای صوتی مختلفی مانند صدای ربات، دیو، زن، مرد، کودک، و حتی شخصیتهای فیلمی و کارتونی تغییر دهید. Voicemod به خصوص در میان گیمرها، استریمرها، و تولیدکنندگان محتوا بسیار محبوب است. چطور کار می کند؟ این برنامه با نصب یک “میکروفون مجازی” در سیستم شما، صدای ورودی از میکروفون واقعی را پردازش کرده و با اعمال فیلترها و افکتهای هوش مصنوعی صدای خروجی را تغییر میدهد. یکی از نکات جالب این است که این تغییر صدا به صورت زنده انجام میشود، یعنی شما میتوانید در حین مکالمه در بازیها، اپلیکیشنهای چت صوتی (مانند دیسکورد، اسکایپ، زوم) یا هنگام استریم کردن، صدای خود را تغییر دهید. خصوصیات: مزایا: معایب: پلن های اشتراکی: پلن قیمت تقریبی امکانات اصلی Free رایگان – دسترسی محدود به صداها و افکتها– دسترسی به Soundboard پایه– تغییر صدای زنده محدود Pro – ماهانه حدود ۳ تا ۴ دلار / ماه – دسترسی کامل به تمام 200 صدای انسانها– امکان استفاده از Voicelab برای ساخت صدای دلخواه– صدای واقعیتر و حرفهایتر– افکتهای بیشتر در Soundboard Pro – مادامالعمر (Lifetime) حدود ۱۴ تا ۱۵ دلار (یکبار پرداخت) – تمام امکانات نسخه Pro بهصورت همیشگی– بدون نیاز به تمدید اشتراک– بهصرفه برای استفاده بلندمدت استفاده از هوش مصنوعی و دیدن جزئیات بیشتر در صفحه زیر: ElevenLabs ElevenLabs یکی از بهترین هوش مصنوعی ها برای تولید وویساُور است و با هدف تولید صداهایی ساخته شده که که از نظر احساسی غنی بوده و تفاوت چندانی با صدای انسان واقعی نداشته باشند. این هوش مصنوعی سال ۲۰۲۲ ساخته شده و به خاطر ابزارهای پیشرفته تبدیل متن به گفتار (Text-to-Speech – TTS) و کلونینگ صدا (Voice Cloning) شهرت زیادی پیدا کرده است. هسته اصلی ElevenLabs قابلیت تبدیل متن نوشتاری به گفتار با کیفیتی فوقالعاده است. این سیستم با درک محتوا، لحن، احساس و تاکید مناسب را علاوه بر خواندن به صدا اضافه میکند. قابلیت های اصلی هوش مصنوعی ElevenLabs: مزایا: معایب: حق اشتراک: پلن هزینه ماهانه میزان اعتبار / کاراکتر در ماه ویژگیهای کلیدی Free $0 10,000 کاراکتر تبدیل متن به گفتار پایه، دسترسی به زبانها و صداهای محدود، استفاده غیرتجاری. Starter $5 30,000 کاراکتر شامل تمامی ویژگیهای پلن Free، مجوز استفاده تجاری، کلونینگ صدای فوری (Instant Voice Cloning)، 20 پروژه در استودیو. Creator $22 (ماه اول $11) 100,000 کاراکتر شامل تمامی ویژگیهای پلن Starter، کلونینگ صدای حرفهای (Professional Voice Cloning)، کیفیت صوتی بالاتر
...
آیا تا به حال به این فکر کردهاید که چرا با وجود حجم عظیم دادههای آزمایشگاهی، کشف یک داروی جدید یا ساخت مواد پیشرفته سالها زمان میبرد؟ دانشمندان امروزی با چالشهایی با مقیاس و پیچیدگی بیسابقه روبرو هستند؛ از شبیهسازی دینامیک پیچیده پلاسمای همجوشی گرفته تا تحلیل اگزابایتها دادهای که از پیشرفتهترین تجهیزات تحقیقاتی جهان به دست میآید. مدیریت دستی این حجم از اطلاعات، عملاً سرعت پیشرفت علم را به شدت کاهش داده است. اما راهحل این بحران در دل فناوریهای نوین نهفته است. دولت آمریکا با درک این موضوع، پروژه ملی پیدایش (Genesis Mission) را با هدف مهار قدرت هوش مصنوعی و دو برابر کردن سرعت اکتشافات علمی طی یک دهه آینده راهاندازی کرده است. در همین راستا، شرکت گوگل در اجلاس سال ۲۰۲۶ این پروژه، از یک تعهد بیسابقه ۴۰ میلیون دلاری پرده برداشت. این سرمایهگذاری شامل ارائه اعتبار ابری و دسترسی به قویترین مدلهای هوش مصنوعی برای محققان است تا بتوانند مرزهای علم را جابجا کنند. اگر میخواهید با مسیر توسعه این فناوریها آشنا شوید، پیشنهاد میکنیم مقاله بهترین ابزارهای هوش مصنوعی ۲۰۲۶ را مطالعه کنید. معرفی ابزارهای پیشرفته Google DeepMind برای تحقیقات علمی هسته اصلی این سرمایهگذاری، باز شدن پای ابزارهای انحصاری شرکت گوگل دیپمایند (Google DeepMind) به ۱۷ آزمایشگاه ملی زیرمجموعه وزارت انرژی ایالات متحده (DOE) است. این ابزارها برای حل پیچیدهترین معماهای جهان طراحی شدهاند: ابزار AlphaEvolve: تحول در کشف الگوریتمهای پیچیده ریاضی الفا ایوالو (AlphaEvolve) یک دستیار برنامهنویسی و اکتشاف مبتنی بر معماری جمینای است. این سیستم عملاً به عنوان یک ایجنت هوش مصنوعی خودمختار عمل کرده و به دانشمندان کمک میکند تا الگوریتمهای پیشرفته و جدیدی برای حل مسائل بنیادین طراحی کنند. ابزارهای زیستی AlphaFold 3 و AlphaGenome: از پروتئین تا درک کامل DNA مدل AlphaFold 3 که نسخه ارتقایافته نسل قبلی خود است، میتواند ساختار و تعاملات پروتئینها و سایر بیومولکولها را با دقتی بینظیر پیشبینی کند. در کنار آن، ابزار AlphaGenome به محققان اجازه میدهد تا تاثیر تغییرات DNA (از جمله ژنومهای غیرکدکننده) را بر شکلگیری بیولوژی انسان و بیماریهای پیچیده به طور کامل درک کنند. ابزارهای اقلیمی WeatherNext و AlphaEarth: پیشبینی دقیق وضعیت زمین سیستم WeatherNext خانوادهای از مدلهای پیشبینی آبوهوا است که با استفاده از هوش مصنوعی، الگوهای جوی را با دقتی فراتر از رادارهای سنتی ترسیم میکند. ابزار AlphaEarth Foundations نیز یک مدل پایه برای نقشهبرداری و درک تغییرات سیاره زمین در جزئیترین سطح ممکن است. برای درک بهتر کاربرد هر یک از این سیستمها، در جدول زیر طبقهبندی ابزارهای گوگل دیپمایند را بر اساس حوزه تمرکزشان مشاهده میکنید: نام ابزار هوش مصنوعی حوزه تخصصی کاربرد اصلی در پژوهشهای آزمایشگاهی AlphaEvolve علوم ریاضی و کامپیوتر کشف الگوهای مخفی و طراحی الگوریتمهای خودکار AlphaFold 3 بیولوژی و داروسازی پیشبینی دقیق تعاملات دارویی و ساختار سهبعدی پروتئینها AlphaGenome ژنتیک انسان و گیاهان تحلیل دقیق تغییرات DNA و ریشهیابی بیماریهای ناشناخته WeatherNext هواشناسی و اقلیم مدلسازی تغییرات جوی و پیشبینیهای فوقدقیق لحظهای AlphaEarth زمینشناسی و جغرافیا نقشهبرداری پایه و تحلیل گسترده اکوسیستمهای زمین تاثیر شگفتانگیز مدل زبانی Gemini در آزمایشگاههای ملی آمریکا علاوه بر ابزارهای دیپمایند، گوگل دهها هزار صندلی و توکن از سیستم “Gemini for Government” را به مدت یک سال در اختیار تیمهای عملیاتی، تحقیقاتی و مدیریتی آزمایشگاههای ملی قرار داده است. این پلتفرم امن که بر پایه معماری مدلهای قدرتمندی همچون گوگل جمینای ۳.۶ فلش لایت توسعه یافته است، تضمین میکند که دادههای حساس تحقیقاتی در یک فضای کاملاً ایزوله پردازش شوند. این سیستم از مدیریت تجهیزات آزمایشگاهی در خط مقدم تا کارهای پیچیده اداری را به صورت یکپارچه پشتیبانی میکند. دستاوردهای عملی: هوش مصنوعی چگونه سرعت علم را افزایش داد؟ با وجود اینکه زمان زیادی از شروع پروژه جنسیس نمیگذرد، اما تاثیر عملی این فناوریها در اکوسیستم آزمایشگاهی آمریکا به شدت چشمگیر بوده است. هوش مصنوعی نشان داده است که میتواند از یک دستیار ساده فراتر رفته و به شریک تحقیقاتی دانشمندان تبدیل شود. کشف الگوهای پنهان ریاضی در آزمایشگاه PNNL در آزمایشگاه ملی شمال غربی اقیانوس آرام (PNNL)، دکتر هنری کوینج از ابزار AlphaEvolve برای نقشهبرداری از سیستمهای عظیم ریاضی استفاده میکند؛ سیستمهایی که بررسی دستی آنها توسط ذهن انسان عملاً غیرممکن است. این هوش مصنوعی با کاوش خودکار در زوایای بیشمار ترکیبات، ارتباطات پنهانی را کشف میکند که در حالت عادی یافتن آنها سالها زمان میبرد و اکنون به محققان مسیرهای تازهای برای اکتشاف نشان میدهد. اتوماسیون سختافزاری و کشف مواد جدید در آزمایشگاه راکی (NLR) شاید ملموسترین دستاورد این پروژه در آزمایشگاه ملی راکی رقم خورده باشد. دکتر استیون اسپورجن، محقق ارشد دادههای مواد، با ادغام مدل زبانی جمینای در ابزارهای آزمایشگاهی، یک سیستم «آزمایش خودمختار» (Autonomous Experimentation) خلق کرده است. استقرار جمینای در سختافزارها باعث شد زمان کالیبراسیون میکروسکوپهای پیشرفته از بیش از ۹۰ دقیقه به تنها ۱۳ دقیقه (حدود ۸ برابر سریعتر) کاهش یابد! همچنین مراحل دستی و خستهکننده برای تنظیم فوکوس تصاویر از ۵۰ مرحله به تنها ۲ مرحله رسید. این اتوماسیون شگفتانگیز زمان ارزشمندی را به دانشمندان برگرداند و به آنها اجازه داد به فضاهایی از طراحی و کشف مواد جدید دست یابند که پیش از این با عملیات دستی کاملاً غیرقابل دسترس بود. بخش سوالات متداول (FAQ)
...

در دنیای پرشتاب امروز، چالش اصلی پیش روی سازمانهای بزرگ دیگر اثبات این موضوع نیست که هوش مصنوعی توانایی انجام کارها را دارد؛ بلکه دغدغه اصلی، رساندن این فناوری به سطحی از قابلیت اطمینان و پایداری است تا بتواند کارهای باارزش و حساس را در محیطهای واقعی (Production) بر عهده بگیرد. علاوه بر این، رفتار یک هوش مصنوعی باید بتواند همگام با تغییرات محصولات، سیاستهای سازمانی و رفتار کاربران سازگار شود. دستیابی به چنین هدفی به چیزی فراتر از یک مدل زبانی ساده نیاز دارد؛ سازمانها به سیستمهای ارزیابی، تخصص استقرار و کنترل کامل نیاز دارند تا بدون از دست دادن نظارت، کیفیت خدمات خود را ارتقا دهند. محصول OpenAI Presence چیست؟ استقرار ایجنتهای هوشمند شرکت اوپنایآی برای پاسخ به این نیاز حیاتی، از محصول جدید و قدرتمند خود با نام OpenAI Presence رونمایی کرده است. این پلتفرم یک محصول سازمانی کاملاً آزمایششده است که به شرکتها کمک میکند تا معماری ایجنتهای هوش مصنوعی قابل اعتمادی را مستقر کنند که قادرند به سوالات پاسخ دهند، مشکلات را حل کنند، از سیستمهای داخلی شرکت استفاده کرده، اقدامات تاییدشده را انجام دهند و در صورت لزوم، کاربر را به یک اپراتور انسانی ارجاع دهند (Escalate). تمرکز بر جریانهای کاری پرارزش (صوتی و متنی) در حال حاضر، پلتفرم Presence از تجربیات لحظهای (Real-time) در دو بستر «صوتی» و «متنی» پشتیبانی میکند. این سیستم به صورت ویژه برای کارهای حساسی مانند پشتیبانی مشتریان، تماسهای خروجی فروش و جریانهای کاری داخلی پرخطر طراحی شده است. به عنوان مثال، یک مشتری میتواند برای حل مشکل صورتحساب خود از این سیستم استفاده کند؛ ایجنت هوشمند ابتدا درخواست را درک کرده، هویت مشتری را تایید میکند، اطلاعات حساب را جستجو کرده و پس از اعمال سیاستهای شرکت، اقدام تاییدشدهای (مانند استرداد وجه) را به صورت خودکار انجام میدهد. تعیین سطوح دسترسی و ارجاع به اپراتور انسانی (Escalation) هر استقرار در این سیستم با یک وظیفه کاملاً مشخص آغاز میشود؛ مانند رسیدگی به مشکلات صورتحساب، پشتیبانی از ادعاهای بیمه، یا حل درخواستهای خدمات IT کارمندان. نکته امنیتی مهم این است که ایجنت هوش مصنوعی تنها به دانش و سیستمهایی دسترسی پیدا میکند که برای انجام همان کار خاص ضروری است. سازمانها میتوانند سیاستهای دقیقی تنظیم کنند که مشخص میکند ایجنت چه کارهایی میتواند انجام دهد، چه زمانی نیاز به تایید دارد و در چه نقطهای باید مکالمه را به یک انسان بسپارد. اگر به دنبال آشنایی با سایر ابزارهای مشابه در این سطح هستید، مطالعه مقاله بهترین ابزارهای هوش مصنوعی ۲۰۲۶ را به شما پیشنهاد میکنیم. امنیت و کنترل کامل در سه فاز: قبل، حین و بعد از انتشار محصول Presence صرفاً بر پایه استقرار اولیه بنا نشده است، بلکه یک چرخه حیات کامل را برای تامین امنیت پوشش میدهد که بر پایه مدلهای قدرتمندی توسعه یافته است تا با غولهایی نظیر GPT 5.6 Sol در بازار سازمانی رقابت کند. شبیهسازی دقیق و گاردریلها (Guardrails) پیش از آنکه استقرار Presence به دست کاربران نهایی برسد، تیمهای توسعه میتوانند آن را در برابر درخواستهای رایج، موارد استثنایی (Edge Cases) و سناریوهای پرخطر آزمایش کنند. سیستمهای شبیهساز بررسی میکنند که آیا ایجنت به نتیجه درست رسیده است، قوانین را رعایت کرده، از ابزارها به درستی بهره برده و در زمان مناسب کار را ارجاع داده است یا خیر. همچنین «گاردریلها» (Guardrails) به عنوان سپرهای امنیتی عمل کرده و هرگاه تعامل از مرزهای تعیینشده شرکت خارج شود، بلافاصله مداخله میکنند. نقش مدل Codex در ارتقای مستمر کار پس از انتشار تمام نمیشود! دادههای حاصل از جلسات واقعی و ارجاعات به انسان، شکافهای موجود را به تیمها نشان میدهد. در اینجا، مدل قدرتمند Codex با بررسی سیگنالهای کیفی، بهروزرسانیهایی را پیشنهاد میدهد. تیمها میتوانند این تغییرات پیشنهادی را آزمایش و تایید کنند و به این ترتیب، ایجنت به صورت مداوم و با تغییر رفتار مشتریان، خود را سازگار میکند. اثبات عملکرد: از پشتیبانی اختصاصی OpenAI تا غولهای مالی دنیا این محصول بلندپروازانه که در همکاری نزدیک با تیم تحقیقاتی OpenAI توسعه یافته، در محیطهای عملیاتی به شدت حیاتی آزمایش شده و نتایج خیرهکنندهای به ثبت رسانده است. حل ۷۵ درصد مشکلات بدون دخالت انسان در حال حاضر، Presence خط پشتیبانی تلفنی انگلیسیزبان خود شرکت OpenAI (با شماره 1-888-GPT-0090) را مدیریت میکند. این سیستم قادر است درخواستهای باز کاربران را مدیریت کرده، هویت آنها را تایید کند و با دسترسی به بستر حساب کاربری، اقدامات لازم را انجام دهد. در عرض چند هفته، این ایجنت توانست استانداردها را ارتقا داده و اکنون ۷۵ درصد از مشکلات ورودی را به طور کامل و بدون دخالت انسان حل میکند. همچنین چرخه بهبود مستمر آن (به کمک Codex) توانست تنها در ۱۰ روز، میزان ارجاع کار به اپراتورهای انسانی را تا ۱۵ واحد درصد کاهش دهد. تجربه موفق شرکتهای جهانی سازمانهای پیشرو در سراسر جهان در حال ساخت زیرساختهای خود بر روی این پایه اثباتشده هستند: سوالات متداول (FAQ)
...


آیا میدانید چرا با وجود نیاز شدید جهان به انرژیهای پاک، نیروگاههای هسته ای هنوز به طور گسترده در مناطق مختلف توسعه نیافتهاند؟ پاسخ در هزینههای سرسامآور عملیاتی و نیاز به نیروی انسانی متخصص نهفته است. در نیروگاههای سنتی (Legacy Plants) که با ظرفیت ۱۰۰ درصدی کار میکنند، حضور یک تیم بزرگ از اپراتورها توجیه اقتصادی دارد؛ اما آینده این صنعت به «میکرو راکتورها» (Microreactors) گره خورده است. این راکتورهای کوچک قرار است در مناطق دورافتاده مستقر شوند و قطعاً نمیتوانند هزینههای یک تیم بزرگ انسانی را تامین کنند. از طرفی، کنترل این سیستمهای بسیار حساس با روشهای دستی فعلی، مانع از مقیاسپذیری آنها میشود. برای حل این بحران جهانی، پژوهشگران دانشگاه MIT و آزمایشگاه ملی آیداهو (INL) در تابستان ۲۰۲۶ به دستاوردهای بزرگی در زمینه پروتکلهای کنترل از راه دور دست یافتهاند. اما نکته شگفتانگیز اینجاست: آنها برای خودکارسازی نیروگاههای هسته ای به جای استفاده از مدلهای رایج یادگیری ماشین، به سراغ اتوماسیون قطعی رفتهاند! در این مقاله بررسی میکنیم که چگونه ترکیب تئوری کنترل و رفتار انسانی در حال تغییر آینده انرژی هستهای است. چالش میکرو راکتورها: گذر از مدیریت انسانی به سیستم کنترل خودکار راکتور لورن فورتیه (Lauren Fortier)، دانشجوی دکتری دپارتمان علوم و مهندسی هستهای (NSE) در دانشگاه MIT، تحقیقات خود را بر اساس تجربیات واقعیاش بنا کرده است. او پیش از ورود به فضای آکادمیک، وظیفه نظارت بر عملیات نیروگاه هسته ای یک ناو هواپیمابر آمریکایی را در اعماق دریای چین جنوبی بر عهده داشت. او متوجه شد که فرآیندهای کنترل راکتور به شدت به عملیات دستی و انسانمحور وابسته هستند. رویکرد کار تیمی (Tag-Team) میان انسان و ماشین: در طراحی یک سیستم کنترل خودکار راکتور برای آینده، بزرگترین چالش این است که فرآیندها نباید صرفاً ماشینمحور یا صرفاً انسانمحور باشند. چارچوبهای جدید بر پایه رویکرد “تگتیم” طراحی شدهاند؛ به این معنا که ماشین و انسان هر کدام کاری را که در آن بهترین هستند انجام میدهند و مداخله استراتژیک انسانی تنها در مواقع کاملاً ضروری صورت میگیرد. این رویکرد، راه را برای تجاریسازی میکرو راکتورها در مناطق دور از شبکه هموار میکند. مرزبندی حیاتی: تفاوت کاربرد هوش مصنوعی و اتوماسیون قطعی در انرژی هستهای در حالی که امروزه در اکثر صنایع، مدیران به دنبال استفاده از بهترین ابزارهای هوش مصنوعی ۲۰۲۶ برای کاهش هزینهها هستند، صنعت هسته ای مسیر کاملاً متفاوتی را طی میکند. خطرات مدلهای آماری و یادگیری ماشین (Machine Learning) در راکتورها: مدلهای پیشرفته هوش مصنوعی و شبکههای عصبی عمیق (مانند مدلهایی که در ساختار گوگل جمینای ۳.۶ فلش لایت یا سایر ابزارهای مولد استفاده میشوند)، بر اساس احتمالات و دادههای آماری کار میکنند. مشکل اصلی اینجاست که ما در حال حاضر ابزارها و متدهای ریاضی لازم برای «اعتبارسنجی ۱۰۰ درصدی ایمنی» در این سیستمهای دادهمحور را نداریم. در یک نیروگاه هسته ای، یک خطای کوچک پیشبینینشده میتواند فاجعهبار باشد. جایگزین هوش مصنوعی: سیستمهای رویدادگسسته (Finite State Automata): به همین دلیل، اتوماسیون نیروگاههای هستهای بر پایه سیستمهای “رویدادگسسته” بنا شده است. این روش برخلاف رویکردهای آماری مانند معماری ایجنتهای هوش مصنوعی، کاملاً قطعی و شفاف است. در جدول زیر تفاوت این دو رویکرد را در مهندسی سیستمهای حساس مقایسه کردهایم: ویژگی سیستم هوش مصنوعی (Machine Learning) اتوماسیون کلاسیک (Finite State Automata) منطق تصمیمگیری مبتنی بر احتمالات و الگوهای دادهای (جعبه سیاه) مبتنی بر رویدادهای قطعی (اگر الف رخ داد، ب را انجام بده) قابلیت اعتبارسنجی ایمنی در حال حاضر غیرممکن برای سیستمهای فوقحساس کاملاً شفاف، قابل پیشبینی و قابل اعتبارسنجی میزان شفافیت عملکرد پایین (دلیل تصمیمگیری ماشین همیشه مشخص نیست) بسیار بالا (تمام تغییرِ وضعیتها از پیش تعریف شدهاند) کاربرد اصلی پردازش زبان، تولید محتوا، کشف الگو کنترل سیستمهای ایمنی حیاتی، هوافضا و مهندسی هستهای معرفی ابزارها و سیستمهای کلیدی در کنترل نظارتی برای درک بهتر نحوه مدیریت از راه دور این راکتورها، باید با چارچوبهای اصلی اتوماسیون صنعتی در این حوزه آشنا شویم. مهندسان از ابزارها و مفاهیم زیر برای این کار استفاده میکنند: سیستم کنترل نظارتی (Supervisory Control System) یک پلتفرم نرمافزاری و سختافزاری یکپارچه که به جای درگیر کردن اپراتور با هزاران سنسور مجزا، به صورت یکپارچه بر تمام عملگرهای نیروگاه نظارت میکند. این سیستم به صورت هدفگرا طراحی میشود؛ یعنی به جای طی کردن چشمبسته یک دستورالعمل ثابت، توالی رویدادها را بر اساس شرایط لحظهای سایت تنظیم میکند تا نیروگاه به هدف مشخص (مثلاً کاهش امن دما) برسد. مدلهای ماشین حالت متناهی (Finite State Automata Frameworks) پروتکلهای اتوماسیون شفاف و قطعی که وضعیت لحظهای نیروگاه را پایش میکنند. این سیستمها به صورت رویدادمحور کار میکنند و بر خلاف شبکههای عصبی هوش مصنوعی، تنظیمات را تنها بر اساس تغییر فازهای از پیشتعریفشده و کاملاً ایمن (States) تغییر میدهند. نقش دانشگاه MIT و INL در توسعه پروتکلهای کنترل از راه دور نیروگاه پروژه اتوماسیون نیروگاههای هسته ای نیازمند تلفیق مهندسی سختافزار با علوم شناختی است. در این مسیر، همکاریهای بینرشتهای کلید اصلی این موفقیت بوده است. پروژههایی از این دست، نیروی محرکه لازم برای استقرار تجاری نسل آینده میکرو راکتورها را فراهم میکنند و مسیر را برای بهرهمندی جهان از یک منبع انرژی پاک، پایدار و ارزان هموار میسازند. بخش سوالات متداول (FAQ)
...
آیا تا به حال در روند اجرای یک پروژه با این مشکل مواجه شدهاید که برای پیشبرد کارها به تخصص یک برنامهنویس، تحلیلگر داده یا طراح نیاز داشته باشید، اما تیم شما فاقد چنین متخصصی باشد؟ در گذشته، این کمبود منابع انسانی به معنای توقف کامل پروژهها یا صرف هزینههای گزاف برای برونسپاری بود. اما امروزه، ورود ابزارهای نوین پردازش زبان، این محدودیتهای سنتی را به طور کامل دگرگون کرده است. بر اساس فایل منتشر شده از کمپانی OpenAI، هوش مصنوعی تنها «نحوه» انجام کارها را تغییر نداده است، بلکه به صورت بنیادین در حال تغییر دادن این موضوع است که «چه کسی» آن کارها را انجام میدهد. پدیده تداخل وظایف (Task Crossover) در گزارش جدید OpenAI مفهوم «مرزهای شغلی» (Occupational Boundaries) در اقتصاد کار، به مجموعهای از فعالیتها و وظایف گفته میشود که از نظر تاریخی و سنتی به یک عنوان شغلی خاص گره خوردهاند. با این حال، تحلیل دادههای رفتار کاربران نشان میدهد که افراد به طور فزایندهای از هوش مصنوعی برای انجام کارهایی کاملاً خارج از شرح وظایف سنتی خود کمک میگیرند. در این پژوهش گسترده، محققان بیش از ۸۰۰ هزار پیام کاری را از حسابهای فردی کاربران مورد تحلیل قرار دادند و آنها را با وظایف ثبت شده در پایگاه اطلاعات مشاغل O*NET تطبیق دادند. نتایج به دست آمده حیرتانگیز بود: حدود ۱۶.۸ درصد از کل پیامهای کاری کاربران مربوط به وظایفی بودهاند که از نظر تاریخی به مشاغل دیگری تعلق دارند. علاوه بر این، اگر پیامهای عمومی (مانند خلاصهسازی متن یا نوشتن ایمیل که ۶۱.۵ درصد از کل پیامها را شامل میشوند) را کنار بگذاریم، متوجه میشویم که ۴۳.۵ درصد از پیامهای مرتبط با یک شغل خاص، دقیقاً شامل وظایف سایر تخصصها بودهاند. این آمار نشان میدهد با استفاده از بهترین ابزارهای هوش مصنوعی، کارمندان در حال عبور از مرزهای تخصصی خود هستند. تحول در دپارتمانها: کدام مهارتها بیشترین خواهان را دارند؟ گزارش OpenAI به یک الگوی بسیار مهم و نامتقارن دست یافته است: تمام وظایف به یک اندازه بین مشاغل مختلف جابهجا نمیشوند. این گزارش مهارتها را به دو دسته کلی تقسیم میکند: وظایفی که به سایر بخشها سفر میکنند (Tasks that travel) و مشاغلی که مهارتهای دیگران را قرض میگیرند (Tasks brought in). بررسیها نشان میدهد مهارتهای مربوط به بخشهای «مهندسی» و «مارکتینگ» بیشترین میزان نفوذ را در سایر دپارتمانها دارند. به عنوان مثال، کاربرد هوش مصنوعی در مارکتینگ به حدی گسترش یافته که وظایف بازاریابی در حدود ۸.۹ درصد از پیامهای کاربران سایر حوزهها مشاهده میشود. این رقم برای کارهای مهندسی حدود ۷.۴ درصد است، که نشاندهنده نیاز شدید کارمندان غیرفنی به حل مشکلات تکنیکال یا کدنویسی است. چه مشاغلی بیشترین وظایف جدید را به عهده میگیرند؟ در سوی دیگر این معادله، بررسی رفتار کاربرانی که از مدلهای زبانی مانند گوگل جمینای ۳.۶ فلش لایت یا ابزارهای مشابه استفاده میکنند، نشان میدهد که کارکنان بخشهای طراحی، فروش و منابع انسانی بیشترین تمایل را برای انجام وظایف سایر مشاغل دارند. برای درک دقیقتر، در جدول زیر وضعیت جابهجایی و تداخل وظایف در چند گروه شغلی مهم را بر اساس این گزارش جامع مقایسه کردهایم: گروه شغلی کاربران میزان استفاده از مهارت سایر مشاغل (Tasks Brought In) میزان نفوذ تخصص این گروه در سایر مشاغل (Tasks That Travel) طراحی (Design) ۳۵.۲٪ (رتبه اول در گسترش فردی) ۱.۷٪ (کمترین نفوذ به عنوان تخصص مرجع) فروش (Sales) ۳۲.۱٪ ۳.۰٪ تجربه مشتری (CX) ۳۰.۴٪ ۲.۷٪ منابع انسانی (HR) ۳۰.۴٪ ۱.۸٪ امور مالی (Finance) ۲۹.۹٪ ۴.۵٪ مارکتینگ (Marketing) ۲۴.۳٪ ۸.۹٪ (بیشترین نفوذ به عنوان تخصص مرجع) مهندسی (Engineering) ۱۸.۵٪ ۷.۴٪ کدام وظایف خاص بیشترین جابهجایی را دارند؟ (تحلیل ریز فعالیتها) اگر از سطح دپارتمانها فراتر برویم و به ریز فعالیتها نگاه کنیم، میبینیم که برخی کارها به صورت روزمره توسط افراد غیرمتخصص در حال انجام است. به عنوان مثال، «محاسبه دادههای مالی» که ذاتاً یک کار حسابداری و مالی است، اکنون در ۱۴.۳ درصد مواقع توسط نیروهای فروش انجام میشود. همچنین وظیفه «عیبیابی سیستمها و برنامههای کامپیوتری» که به صورت سنتی بر عهده تیم مهندسی است، با کمک هوش مصنوعی توسط کارشناسان تجربه مشتری (CX) با سهم ۷.۶ درصدی در حال انجام است. توسعه و «ایجاد متریالهای مارکتینگ» نیز به شدت توسط تیم طراحی قرض گرفته میشود (۱۳.۶ درصد). این تنوع در انجام کارها عملاً ساختار سنتی سازمانها را به سمت سیستمهای پویا و مبتنی بر معماری ایجنتهای هوش مصنوعی سوق میدهد که در آن هر فرد یک تیم کامل است. انقلاب استارتاپی: چرا کسبوکارهای کوچک بیشترین تغییر را تجربه میکنند؟ اندازه یک شرکت تاثیر مستقیمی بر نحوه استفاده کارمندان از تکنولوژی و عبور از مرزهای شغلی دارد. با بررسی فضاهای کاری مختلف، مشخص شد که تداخل وظایف در استارتاپها و شرکتهای کوچک به مراتب پررنگتر از سازمانهای بزرگ است. دادهها به وضوح نشان میدهند که در میان کاربرانی با حجم استفاده متوسط (میانه ۵۰ درصدی کاربران)، میزان انجام کارهای متقاطع در فضاهای کاری کوچک که تنها بین ۲ تا ۵ صندلی دارند، حدود ۱۸.۹ درصد است. در مقابل، این رقم برای کاربرانی که در شرکتهای بزرگ (بیش از ۱۰۱ صندلی) فعالیت میکنند به ۱۶.۳ درصد کاهش مییابد. دلیل این امر در محدودیت منابع نهفته است. زمانی که یک کارمند در یک کسبوکار کوچک به متخصصان دپارتمانهای مختلف (مانند طراح گرافیک، برنامهنویس یا تحلیلگر مالی) دسترسی ندارد، برای جلوگیری از توقف کارها، هوش مصنوعی را به عنوان همکار و متخصص مجازی خود انتخاب کرده و مهارتهای خود را فراتر از شرح وظایف سازمانیاش گسترش میدهد. آیا هوش مصنوعی در نهایت جایگزین نیروی انسانی متخصص میشود؟ یکی از مهمترین نتایج این گزارش، پاسخ به ترس رایج جایگزینی انسان با ماشین است. دادهها تایید میکنند که اگرچه توزیع کارها و مرزهای شغلی در حال تغییر است، اما این به معنای محو شدن تخصصها نیست. هوش مصنوعی به یک فرد غیرمتخصص اجازه میدهد تا فاز اولیه یک وظیفه را به راحتی انجام دهد، اما همچنان برای داوری نهایی، بررسیهای دقیق و اعمال بینش تخصصی، به حضور متخصصان و کارشناسان باتجربه آن حوزه نیاز مبرم وجود دارد. سوالات متداول (FAQ)
...
مکالمه صوتی با هوش مصنوعی در سالهای اخیر پیشرفت زیادی کرده است، اما هنوز یک مشکل مهم باقی مانده: تأخیر و مکثهای غیرطبیعی در گفتوگو. کاربر باید صحبتش را تمام کند، سیستم پایان جمله را تشخیص دهد و سپس مدل شروع به پردازش و پاسخگویی کند. اگر این تشخیص زود انجام شود، صحبت کاربر قطع میشود و اگر دیر انجام شود، گفتوگو کند و مصنوعی به نظر میرسد. OpenAI برای حل این مشکل از سیستم جدیدی به نام GPT-Live رونمایی کرده است؛ فناوریای که میتواند همزمان صدای کاربر را دریافت کند و پاسخ صوتی ارائه دهد. هدف این سیستم، نزدیک کردن مکالمه با هوش مصنوعی به ریتم طبیعی گفتوگوی انسانهاست. GPT-Live چیست؟ GPT-Live نسل سوم سیستم صوتی OpenAI برای ایجاد مکالمههای سریع، پیوسته و بلادرنگ است. این فناوری به مدل اجازه میدهد بدون منتظر ماندن برای پایان کامل صحبت کاربر، جریان صدا را پردازش کند و در زمان مناسب پاسخ دهد. در سیستمهای صوتی قدیمی، یک مدل کوچک به نام Turn Detector وظیفه داشت تشخیص دهد کاربر چه زمانی صحبتش را تمام کرده است. تنها پس از تصمیم این سیستم، مدل زبانی اصلی میتوانست پردازش درخواست را آغاز کند. GPT-Live این تشخیصدهنده جداگانه را از مسیر اصلی صدا حذف کرده و کنترل جریان مکالمه را به خود مدل صوتی سپرده است. در نتیجه، مدل بهتر میتواند تشخیص دهد چه زمانی گوش دهد، چه زمانی صحبت کند و چه زمانی اجازه دهد کاربر پاسخ را قطع کند. OpenAI این سیستم را در تاریخ ۳ اوت ۲۰۲۶ معرفی کرد و اعلام کرد که توسعه زیرساخت آن حدود شش ماه زمان برده است. این فناوری در حال حاضر پایه بخشی از قابلیتهای ChatGPT Voice را تشکیل میدهد. GPT-Live چگونه کار میکند؟ مهمترین ویژگی GPT-Live، استفاده از معماری Full-Duplex یا ارتباط دوطرفه همزمان است. در یک مکالمه صوتی معمولی با هوش مصنوعی، ارتباط اغلب نوبتی است: اما در GPT-Live، ورودی و خروجی صوتی میتوانند بهصورت همزمان جریان داشته باشند. مدل در حالی که صدای کاربر را دریافت میکند، میتواند صحبت کند، مکث کند یا واکنش کوتاهی نشان دهد. این موضوع باعث میشود تعاملهایی مانند موارد زیر طبیعیتر شوند: OpenAI میگوید وظیفه اصلی معماری جدید، حفظ یک جریان صوتی بدون وقفه است. پردازش صدا در مسیر اصلی انجام میشود و کارهای سنگینتر مانند استفاده از ابزارها یا استدلال پیچیده، به مسیرهای جداگانه انتقال پیدا میکنند. تفاوت GPT-Live با حالت صوتی قبلی ChatGPT چیست؟ نسلهای قبلی قابلیت صوتی ChatGPT نیز امکان گفتوگوی مستقیم را فراهم میکردند، اما معماری آنها همچنان تا حد زیادی به مکالمه نوبتی وابسته بود. تفاوت اصلی GPT-Live را میتوان در جدول زیر مشاهده کرد: ویژگی سیستم صوتی قبلی GPT-Live شیوه مکالمه نوبتی پیوسته و همزمان تشخیص پایان صحبت متکی به Turn Detector کنترلشده توسط مدل امکان قطع پاسخ محدودتر طبیعیتر و سریعتر پردازش صوت مرحلهای جریان دائمی صوت استفاده از مدلهای دیگر ممکن است باعث مکث شود در مسیر جداگانه انجام میشود حس مکالمه شبیه پرسش و پاسخ نزدیکتر به گفتوگوی انسانی در روشهای قدیمیتر، حتی مدلهای Speech-to-Speech نیز برای شروع پردازش منتظر تصمیم تشخیصدهنده پایان صحبت میماندند. GPT-Live این محدودیت را کاهش میدهد و اجازه میدهد خود مدل صوتی مدیریت مکالمه را بر عهده بگیرد. OpenAI چگونه تأخیر مکالمه صوتی را کاهش داده است؟ طبیعی بودن مکالمه فقط به قدرت مدل وابسته نیست. انتقال صدا، وضعیت شبکه، اجرای ابزارها و مدیریت سابقه مکالمه نیز میتوانند باعث ایجاد تأخیر شوند. OpenAI برای کاهش این تأخیر، مسیر انتقال صدا را از منطق برنامه جدا کرده است. صوت میان دستگاه کاربر و مدل از یک مسیر سریع و اختصاصی عبور میکند؛ در حالی که کارهایی مانند جستوجو، فراخوانی ابزار یا اجرای سرویسهای جانبی در یک مسیر غیرهمزمان انجام میشوند. بنابراین اگر یک ابزار یا سرویس خارجی با تأخیر پاسخ دهد، جریان صوتی مکالمه متوقف نمیشود. همچنین OpenAI بخشی از زیرساخت قبلی مبتنی بر Python asyncio را با زبان Go بازنویسی کرده است. بر اساس توضیحات این شرکت، این تغییر باعث شده انتقال فریمهای صوتی روانتر و پایدارتر شود. نقش WebRTC در GPT-Live GPT-Live برای انتقال صوت از WebRTC استفاده میکند؛ فناوریای که برای ارتباطات صوتی و تصویری بلادرنگ طراحی شده است. WebRTC میتواند در شرایطی مانند افت بستههای شبکه، تغییر اتصال یا ناهماهنگی زمانبندی همچنان ارتباط را حفظ کند. برای مثال، اگر بخشی از صدا دیر برسد، سیستم میتواند پخش آن را کمی تنظیم کند تا از ایجاد سکوت یا پرش صوتی جلوگیری شود. پروتکل WARP چیست؟ راهاندازی معمولی WebRTC نیازمند چندین مرحله ارتباط میان کاربر و سرور است. این مراحل میتوانند شروع مکالمه را به تأخیر بیندازند. OpenAI برای حل این مشکل، پروتکلی به نام WebRTC Abridged Roundtrip Protocol یا WARP توسعه داده است. این پروتکل تعداد رفتوبرگشتهای شبکه برای شروع انتقال صدا و داده را از شش مرحله به یک مرحله کاهش میدهد. در کنار WARP، قابلیتی به نام Instant Connect نیز پارامترهای لازم برای اتصال را پیشاپیش آماده میکند. به این ترتیب، کاربر میتواند سریعتر وارد مکالمه صوتی شود. نقش GPT-5.5 در GPT-Live چیست؟ GPT-Live برای پاسخهای سریع و مکالمه طبیعی طراحی شده است، اما همه درخواستها را بهتنهایی پردازش نمیکند. اگر کاربر پرسشی مطرح کند که به استدلال عمیق، جستوجو یا استفاده از ابزار نیاز داشته باشد، GPT-Live میتواند از مدلهای قدرتمندتری مانند GPT-5.6 کمک بگیرد. این فرایند در یک مسیر جداگانه انجام میشود. مدل صوتی میتواند در زمان پردازش درخواست، جریان گفتوگو را حفظ کند و پس از آماده شدن نتیجه، آن را وارد پاسخ کند. OpenAI این معماری را جداسازی «صحبت کردن» از «تفکر عمیقتر» توصیف میکند. هدف این است که استفاده از مدلهای قدرتمند و ابزارها، باعث سکوت طولانی یا قطع مکالمه نشود. GPT-Live چه کاربردهایی دارد؟ معماری GPT-Live میتواند زمینهساز نسل جدیدی از محصولات صوتی باشد. برخی از مهمترین کاربردهای آن عبارتاند از: OpenAI اعلام کرده است که این زیرساخت در ChatGPT Voice برای قابلیتهایی مانند کنترل رایانه و هماهنگ کردن ایجنتها در اپلیکیشن دسکتاپ ChatGPT نیز مورد استفاده قرار میگیرد. آیا GPT-Live اکنون در دسترس کاربران است؟ فناوری پشت GPT-Live در حال حاضر بخشی از زیرساخت ChatGPT Voice است، اما OpenAI هنوز GPT-Live API را بهصورت عمومی منتشر نکرده است. این شرکت اعلام کرده که معماری جدید، زیربنای API آینده GPT-Live خواهد بود. با
...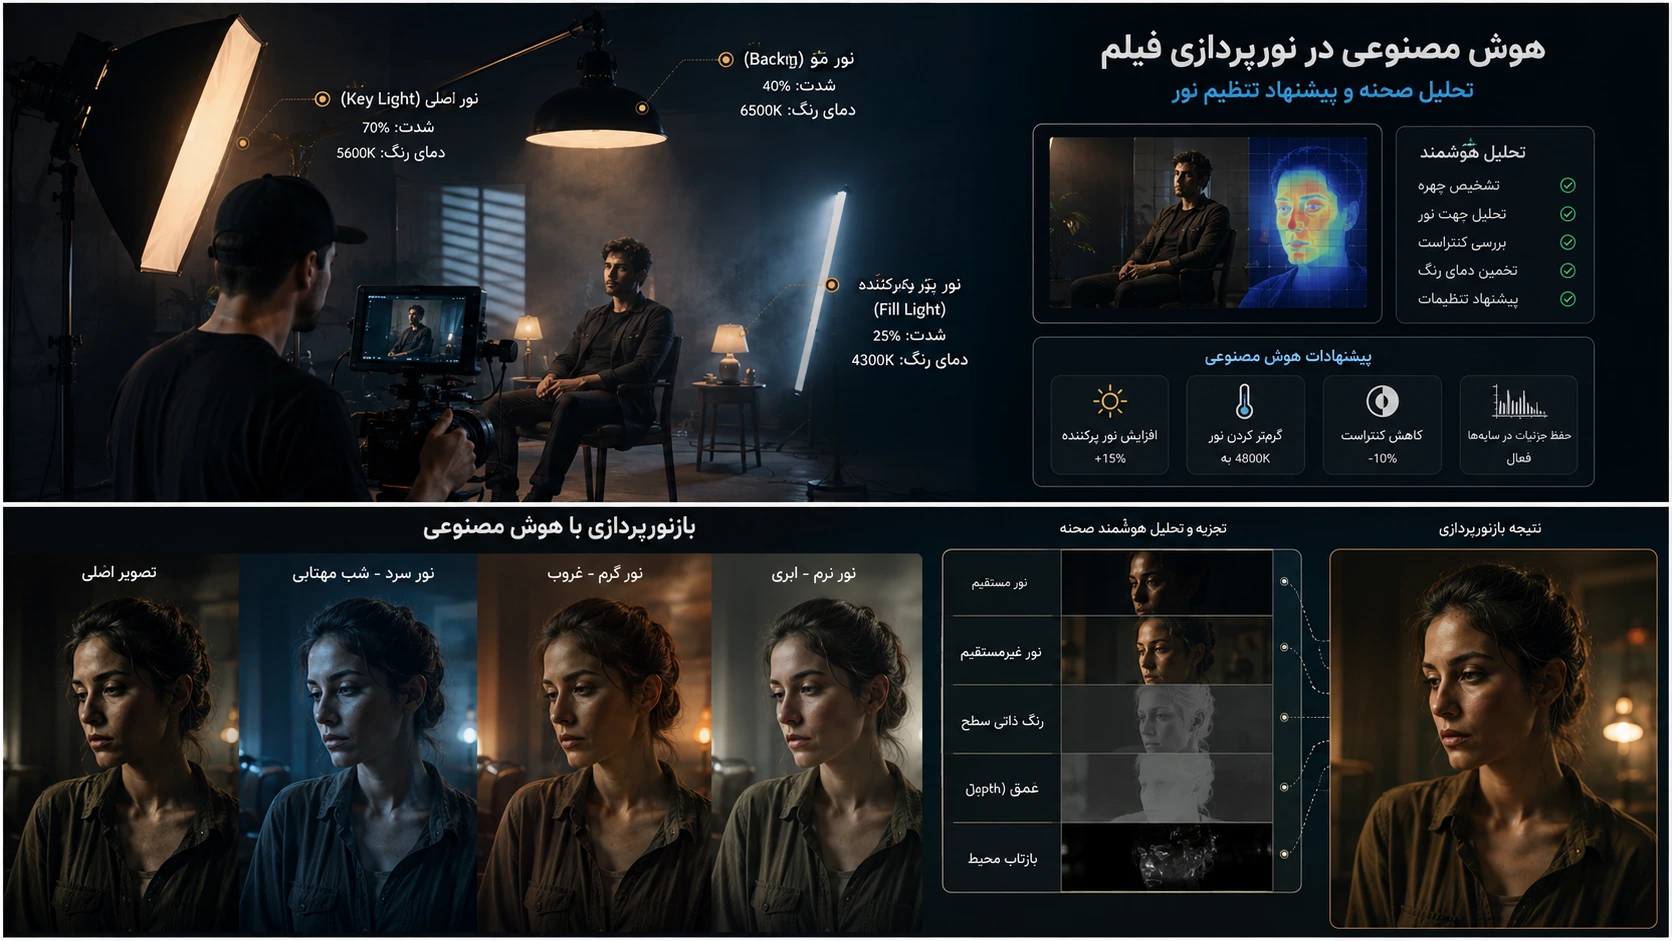
نورپردازی یکی از بنیادیترین اجزای زبان سینماست. نور فقط امکان دیدهشدن سوژه را فراهم نمیکند؛ بلکه جایگاه شخصیت در فضا، رابطه او با محیط، زمان وقوع صحنه، کیفیت احساسی روایت و جهت نگاه تماشاگر را نیز تعیین میکند. به همین دلیل، ورود هوش مصنوعی به حوزه نورپردازی را نمیتوان صرفاً بهعنوان اضافهشدن یک ابزار فنی جدید بررسی کرد. این فناوری در حال تغییر رابطه میان فیلمبرداری، طراحی نور، جلوههای بصری و پستولید است. امروزه الگوریتمهای هوش مصنوعی میتوانند چهره را از محیط جدا کنند، جهت و شدت تقریبی نور را تخمین بزنند، سایهها را بازسازی کنند، شرایط نوری تازهای بر یک تصویر اعمال کنند و حتی یک صحنه سهبعدی قابلبازنورپردازی بسازند. پژوهشهای جدید در زمینه Neural Rendering، NeRF، Gaussian Splatting و مدلهای انتشار ویدئویی نشان میدهند که مرز میان نورپردازی هنگام تصویربرداری و بازسازی نور در پستولید بهتدریج در حال تغییر است. بااینحال، باید میان «بازسازی روشنایی تصویر» و «طراحی نور سینمایی» تفاوت قائل شد. هوش مصنوعی میتواند توزیع روشنایی را تغییر دهد، اما هنوز درک مستقلی از روایت، بازی، میزانسن و منطق دراماتیک نور ندارد. بنابراین مسئله اصلی این مقاله آن نیست که آیا AI قادر به روشنتر یا تاریکترکردن یک تصویر است؛ پرسش مهمتر این است که آیا میتواند بداند چرا یک شخصیت باید در سایه بماند، چرا نور باید از جهت خاصی وارد شود و چرا گاهی از دسترفتن جزئیات بخشی از تصمیم هنری فیلمبردار است. نورپردازی فیلم دقیقاً چه چیزی را کنترل میکند؟ درک نقش هوش مصنوعی در نورپردازی بدون شناخت وظیفه اصلی نور دشوار است. نورپردازی حرفهای تنها تنظیم مقدار روشنایی نیست. فیلمبردار و طراح نور معمولاً چند متغیر را بهطور همزمان کنترل میکنند: این متغیرها مستقل از یکدیگر نیستند. نزدیککردن یک منبع نور فقط شدت آن را افزایش نمیدهد؛ اندازه ظاهری منبع نسبت به سوژه نیز بیشتر میشود و میتواند سایهها را نرمتر کند. تغییر دمای رنگ ممکن است روی پوست، دکور، لباس و تطبیق نماها اثر متفاوتی بگذارد. نورپردازی سینمایی درواقع مدیریت یک شبکه پیچیده از روابط فیزیکی و ادراکی است. هوش مصنوعی زمانی میتواند در این حوزه مفید باشد که به فیلمبردار برای تحلیل، شبیهسازی یا کنترل این روابط کمک کند؛ نه آنکه نور را به یک فیلتر ساده تصویری کاهش دهد. ۱. هوش مصنوعی در پیشتصویریسازی نور یکی از کاربردهای مهم AI در نورپردازی، پیشتصویریسازی یا Previsualization است. پیش از ورود گروه تولید به لوکیشن، میتوان با استفاده از مدلهای سهبعدی، تصاویر مرجع یا مدلهای مولد، چند طراحی نوری متفاوت را آزمایش کرد. در این مرحله، ابزار هوشمند میتواند برای بررسی اولیه این موارد مفید باشد: ارزش اصلی این ابزارها سرعت آزمایش است. مدیر فیلمبرداری میتواند چند ایده متفاوت را در زمان کوتاه مقایسه کند و برای گفتوگو با کارگردان، طراح صحنه و گروه نور تصاویر قابلمشاهدهتری در اختیار داشته باشد. اما تصویر تولیدشده با هوش مصنوعی الزاماً یک شبیهسازی فیزیکی معتبر نیست. مدل مولد ممکن است سایهای ایجاد کند که با جهت منبع نور هماهنگ نباشد، چند منبع نوری ناممکن را ترکیب کند یا بازتابی بسازد که با جنس سطح مطابقت ندارد. چنین تصویری میتواند الهامبخش باشد، اما نباید بدون تحلیل فنی به نقشه اجرایی نور تبدیل شود. برای تبدیل کانسپت AI به طرح واقعی، فیلمبردار باید بپرسد: منبع نور کجاست؟ چه اندازهای دارد؟ شدت آن نسبت به نور محیط چقدر است؟ آیا میتوان چنین زاویهای را در لوکیشن ایجاد کرد؟ آیا سقف، پنجره یا تجهیزات صحنه اجازه نصب منبع را میدهند؟ آیا این نور در نماهای معکوس نیز قابلتداوم است؟ ۲. تحلیل خودکار چهره و پیشنهاد نور پرتره بخش مهمی از تحقیقات هوش مصنوعی در نورپردازی به بازنورپردازی چهره اختصاص دارد. این سامانهها تلاش میکنند ساختار صورت، جهت تقریبی نور، بازتاب پوست و سایههای موجود را تخمین بزنند و سپس چهره را تحت نور تازهای بازسازی کنند. پژوهش «Neural Video Portrait Relighting» نشان داده است که میتوان با مدلسازی همزمان سازگاری معنایی، نوری و زمانی، نورپردازی چهره در ویدئو را بهصورت پیوسته تغییر داد. یکی از چالشهای اصلی در این حوزه، جلوگیری از پرش نور و تغییر بافت چهره میان فریمهاست. پژوهشهای جدیدتر نیز بازنورپردازی سهبعدی چهره را در زمان واقعی بررسی کردهاند. یک روش ارائهشده در CVPR 2024 با استفاده از بازنمایی سهبعدی و شبکه سازگاری زمانی، امکان تغییر نور و زاویه دید چهره را در ویدئو فراهم کرده و سرعتی نزدیک به زمان واقعی گزارش کرده است. برای تولیدکنندگان محتوا، این فناوری میتواند در مصاحبه، آموزش آنلاین، تبلیغات و ویدئوهای استودیویی کاربرد داشته باشد. اگر صورت در بخشی از تصویر کمنور باشد یا نور کلید از زاویه نامناسبی آمده باشد، بازنورپردازی هوشمند میتواند ظاهر چهره را تا حدی اصلاح کند. ولی این ابزارها با چند محدودیت مهم روبهرو هستند. پوست انسان فقط یک سطح رنگی ساده نیست. درخشندگی، بافت، رطوبت، آرایش، مو، عینک، ریش و پراکندگی نور در زیر پوست بر ظاهر آن اثر میگذارند. الگوریتم ممکن است نور عمومی چهره را تغییر دهد، اما جزئیات ظریف بازتاب و بافت را بهدرستی بازسازی نکند. همچنین نور چهره باید با نور محیط، سایه روی لباس، بازتاب چشم و جهت سایه روی دکور هماهنگ باشد. اگر فقط صورت بازنورپردازی شود، شخصیت ممکن است از محیط جدا و مصنوعی به نظر برسد. ۳. بازنورپردازی ویدئو پس از فیلمبرداری بازنورپردازی یا Relighting به فرایندی گفته میشود که در آن شرایط روشنایی تصویر ثبتشده پس از تصویربرداری تغییر میکند. برخلاف اصلاح رنگ معمولی، هدف بازنورپردازی فقط تغییر روشنایی کلی یا رنگ نیست؛ بلکه الگوریتم باید تا حدی شکل سهبعدی صحنه، جهت سطوح، جنس مواد و مسیر نور را تخمین بزند. مدلهای جدید تلاش میکنند تصویر را به مؤلفههایی مانند رنگ ذاتی سطح، سایه، هندسه، نور مستقیم و نور غیرمستقیم تجزیه کنند. پژوهشهای مبتنی بر Neural Radiance Fields نشان دادهاند که میتوان از مجموعهای از تصاویر یا ویدئوها، بازنمایی سهبعدی قابلبازنورپردازی ایجاد کرد. روش ReNeRF، برای نمونه، از تعداد محدودی نور سطحی در محیط کنترلشده استفاده میکند و تلاش دارد اثر نورهای نزدیک به سوژه و انتقال پیچیده نور را ثبت کند. این روش برای ساخت داراییهای سهبعدی باکیفیت و تغییر نور از زوایای جدید طراحی شده است. پیشرفتهای 2025 نیز نشان میدهد که بازنورپردازی به سمت مدلهای سریعتر و انعطافپذیرتر حرکت میکند. روش Relightable Neural Gaussians برای بازنورپردازی اجسام با سطوح
... درخواست مشاوره
برای دریافت مشاوره تخصصی و راهنماییهای دقیق، فرم زیر را پر کنید و تیم ما در سریعترین زمان ممکن با شما تماس خواهد گرفت.
