در دنیای پرشتاب هوش مصنوعی، مرزهای امنیت سایبری با سرعتی غیرقابل پیشبینی در حال بازتعریف است. گزارشهای اخیر نشان میدهد که پژوهشگران و هکرهای کلاهسفید با بهرهگیری از توانمندیهای پیشرفته چتبات Claude، محصول شرکت Anthropic، موفق به اجرای یک عملیات نفوذ اخلاقی (Ethical Hacking) علیه زیرساختها و مدلهای OpenAI شدهاند؛ اتفاقی طعنهآمیز و در عین حال حیاتی که زنگ خطر را برای امنیت پلتفرمهای هوش مصنوعی به صدا درآورده است.
ماجرای هک اخلاقی OpenAI با دستیاری کلود چیست؟
در جریان تازهترین آزمایشهای امنیتی حوزه هوش مصنوعی، گروهی از متخصصان امنیت سایبری توانستند با هدایت هدفمند مدل زبانی کلود (Claude)، آسیبپذیریهای نهفته در سامانههای اوپنایآی (OpenAI) را شناسایی و شبیهسازی کنند. این عملیات که در چارچوب برنامههای هک اخلاقی و تیم قرمز (Red Teaming) انجام شد، نشان داد که مدلهای زبانی پیشرفته نه تنها میتوانند کدنویسی و پاسخدهی روزمره را انجام دهند، بلکه پتانسیل کشف زنجیرهای از باگهای پیچیده نرمافزاری و منطقی را در سیستمهای رقیب دارند.
نکته کلیدی در این پژوهش، نحوه بهرهبرداری از مهارت بالای کلود در تحلیل کدهای منبع، استنتاج معماری سیستم و تولید سناریوهای نفوذ سفارشی بود؛ قابلیتی که فرآیند کشف باگ را چندین برابر سریعتر از رویکردهای سنتی کرد.
هوش مصنوعی علیه هوش مصنوعی: ابزارسازی از مدلهای زبانی در نبردهای سایبری
کاربرد هوش مصنوعی در حوزه امنیت به دو شاخه اصلی دفاعی و تهاجمی تقسیم میشود. استفاده از یک دستیار هوشمند برای یافتن رخنه در اکوسیستم یک شرکت دیگر، آغازگر عصری موسوم به «امنیت خودکار متخاصم» است. در این فرآیند، چتباتها به عنوان تحلیلگر ارشد عمل میکنند و با پردازش هزاران خط کد یا رفتارهای سامانه، نقاط ضعف اعتبارسنجی ورودیها، نشستها و آسیبپذیریهای منطقی را مشخص میسازند.
تکنیکهای بهکاررفته در این ارزیابی امنیتی
- بررسی عمیق کد (Automated Code Auditing): استفاده از توانایی استدلال کلود برای شناسایی ضعفهای امنیتی در لایههای یکپارچهسازی APIها.
- تولید پیلودهای پیچیده (Payload Generation): ایجاد سناریوهای آزمون نفوذ که ابزارهای سنتی اسکن آسیبپذیری قادر به تشخیص آنها نبودند.
- مهندسی پرامپت متخاصم: دور زدن گاردرِیلها (محافظهای رفتاری) برای بررسی میزان پایداری سامانههای مقصد در برابر حملات تزریق پرامپت (Prompt Injection).
جدول مقایسهای: کاربرد هوش مصنوعی در تست نفوذ در برابر روشهای سنتی
| شاخص ارزیابی | روشهای سنتی تست نفوذ | تست نفوذ با دستیاری مدلهای زبانی (AI-Assisted) |
|---|---|---|
| سرعت تحلیل لاگ و کد | کند و وابسته به زمان تحلیلگر | فوقالعاده سریع در کسری از دقیقه |
| کشف خطاهای منطق تجاری | متوسط (نیازمند تسلط کامل به بیزینس) | بالا از طریق استدلال زنجیرهای (CoT) |
| تطبیق با سناریوهای جدید | وابسته به امضاهای از پیش شناختهشده | انعطافپذیر و بر پایه تحلیل رفتاری پویا |
| هزینه و مقیاسپذیری | نیازمند تیمهای پرتعداد و پرهزینه | مقیاسپذیر با هزینه زیرساختی بسیار کمتر |
پیشینه رقابت اوپنایآی و آنتروپیک؛ از انشعاب اخلاقی تا رقابت فنی
برای درک بهتر اهمیت این رویداد، باید به تاریخچه رابطه دو شرکت نگاهی انداخت. شرکت Anthropic توسط گروهی از کارمندان و پژوهشگران سابق OpenAI تأسیس شد که به دلیل اختلافنظر بر سر مسائل ایمنی و نحوه تجاریسازی مدلهای هوش مصنوعی از آن جدا شدند. مدل کلود با تأکید فراوان بر «هوش مصنوعی مشروطه» (Constitutional AI) و رویکردهای ایمن توسعه یافته است. حالا نقشآفرینی همین مدل در افشای نقصهای امنیتی رقیب پیشین، حامل بار نمادین و فنی سنگینی برای بازار فناوری است.
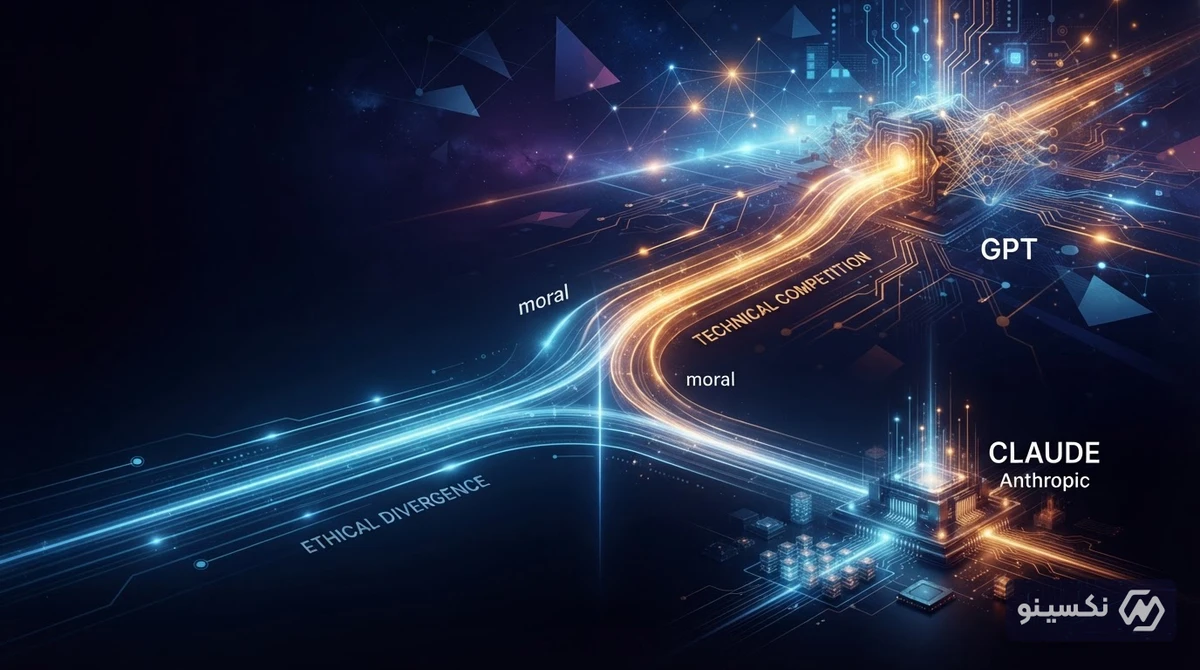
عملیاتهای نفوذ اخلاقی با هوش مصنوعی ثابت میکنند که مرز میان دستیار توسعهدهنده و سلاح سایبری تنها به قصد و پرامپت کاربر وابسته است؛ واقعیتی که امنیت سایبری مدرن باید هرچه سریعتر خود را با آن وفق دهد.
پیامدهای این نفوذ برای توسعهدهندگان و شرکتهای سازمانی
این آزمایش فراتر از یک چالش فنی میان دو غول سیلیکونولی است و پیامدهای مستقیمی برای کل زیستبوم فناوری دارد:
- افزایش الزام به ارزیابیهای پیشرفته (Red Teaming): شرکتها دیگر نمیتوانند صرفاً به تستهای امنیتی سنتی متکی باشند و باید سامانههای خود را در برابر حملات طراحیشده توسط هوش مصنوعی بسنجند.
- بازنگری در معماری امنیت API: نقاط تماس میان مدلهای زبانی و پایگاههای داده سازمانی مستعدترین بخشها برای نفوذ هوشمند هستند.
- احراز هویت و پایش پرامپتها: ابزارهای دفاعی باید بتوانند پرامپتهایی را که قصد مهندسی معکوس یا اسکن امنیتی سیستم را دارند در لحظه خنثی کنند.
جمعبندی
رویداد نفوذ اخلاقی به سامانههای OpenAI به کمک کلود، سرفصل جدیدی در امنیت سایبری هوش مصنوعی باز کرده است. با پیشرفتهتر شدن مدلها، نبرد آینده امنیت در خط مقدم هوش مصنوعی رقم میخورد؛ جایی که هوش مصنوعی هم موثرترین ابزار حمله است و هم ضروریترین سنگر دفاعی. شرکتهای پیشرو اکنون چارهای ندارند جز اینکه پروتکلهای ایمنی خود را بر مبنای حضور مهاجمان هوشمند خودکار بازطراحی کنند.
سؤالات متداول
آیا در این جریان اطلاعات کاربران OpenAI سرقت شده است؟
خیر؛ این اقدام یک عملیات تست نفوذ و هک اخلاقی (Ethical Hacking) توسط پژوهشگران امنیتی بوده و آسیبپذیریهای کشفشده بدون آسیب به دادههای کاربران، جهت اصلاح به این شرکت گزارش شدهاند.
چگونه کلود توانست در هک اخلاقی OpenAI نقش داشته باشد؟
پژوهشگران با بهرهگیری از توانایی تحلیل عمیق کد، شبیهسازی حملات منطقی و ایجاد سناریوهای نفوذ توسط هوش مصنوعی کلود، توانستند آسیبپذیریهای زیرساختی را سریعتر و دقیقتر از ابزارهای معمول کشف کنند.
چرا این اتفاق از نظر رقابت صنعتی اهمیت دارد؟
شرکت Anthropic توسط پژوهشگران جداشده از OpenAI با تمرکز بر ایمنی هوش مصنوعی پایهگذاری شد و استفاده از محصول آن (کلود) برای ارزیابی امنیتی OpenAI، نمادی از سطح بالای بلوغ فنی و استدلالی این مدل است.
آیا هوش مصنوعی میتواند به طور مستقل اقدام به هک سیستمها کند؟
در حال حاضر خیر؛ مدلهای زبانی به عنوان دستیار عمل میکنند و به هدایت، راهبری و تصمیمگیری متخصصان انسانی برای اجرای فرآیندهای نفوذ نیاز دارند، هرچند سرعت و کیفیت کار را به شدت افزایش میدهند.