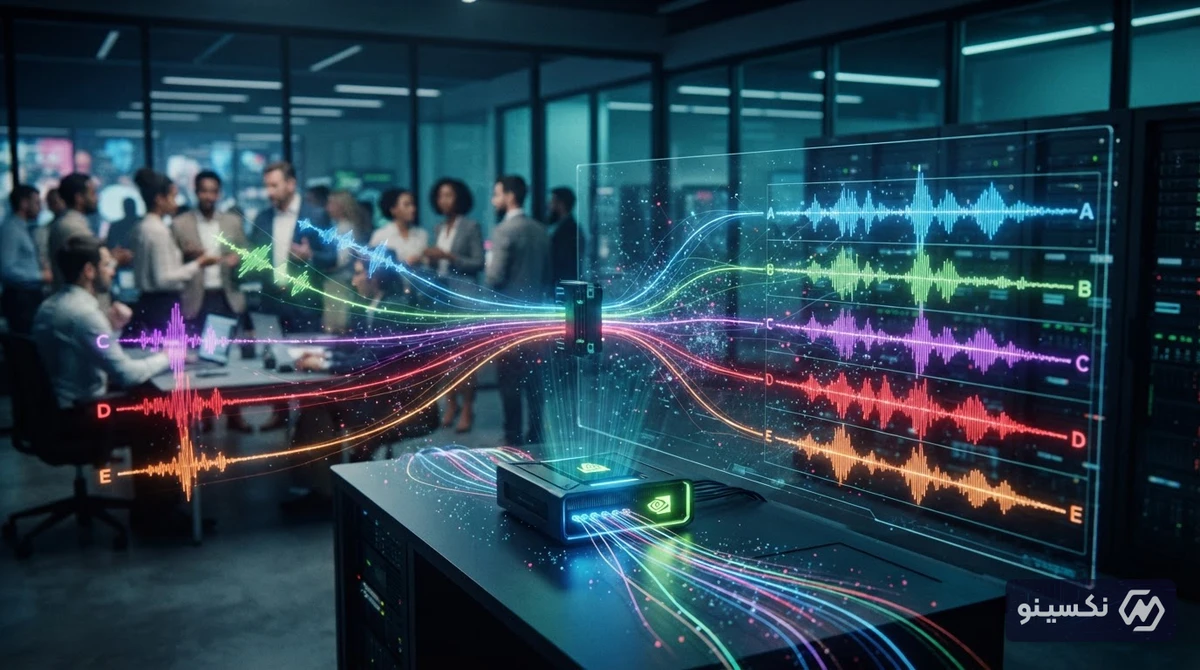
در دنیای پردازش زبان طبیعی و هوش مصنوعی صوتی، یکی از دشوارترین چالشها همواره این بوده است که سیستم دقیقاً متوجه شود «چه کسی، چه زمانی صحبت کرده است». شرکت انویدیا (NVIDIA) با رونمایی از مدل پیشرفته Nemotron 3 Diarization گام بلندی در حل این معضل برداشته و امکان تفکیک گویندگان در مکالمات چندنفره را بهصورت بلادرنگ (Real-Time) فراهم کرده است.
فناوری تفکیک گوینده (Speaker Diarization) چیست و چرا اهمیت دارد؟
هنگامی که به فایلهای صوتی ضبطشده از جلسات، پادکستها یا تماسهای پشتیبانی گوش میدهید، مغز انسان بهراحتی لحن و جنس صدای اشخاص مختلف را تشخیص داده و تفکیک میکند. اما برای الگوریتمهای هوش مصنوعی، زمانی که چند نفر همزمان صحبت میکنند یا در محیط نویز وجود دارد، این فرایند فوقالعاده پیچیده میشود. به این تکنولوژی که وظیفه قطعهبندی فایل صوتی بر اساس هویت گویندگان را دارد، تفکیک گوینده (Speaker Diarization) میگویند.
تا پیش از این، اکثر مدلهای موجود نیازمند ارسال کل فایل صوتی به سرور و پردازش آفلاین پس از اتمام مکالمه بودند. این محدودیت، استفاده از هوش مصنوعی را در جلسات زنده یا برنامههای تعاملی با تأخیر روبهرو میکرد. انویدیا با توسعه مدل Nemotron 3 Diarization این مانع بزرگ را کنار زده است.
ویژگیهای کلیدی مدل Nemotron 3 Diarization انویدیا
انویدیا در ساخت این مدل از اکوسیستم یادگیری عمیق و فریمورک اختصاصی NeMo بهره برده است تا بالاترین سطح بهینهسازی را روی پردازندههای گرافیکی (GPU) خود پیادهسازی کند. مهمترین ویژگیهای این مدل شامل موارد زیر است:
- پردازش بلادرنگ با کمترین میزان تأخیر (Ultra-Low Latency): امکان تحلیل سیگنال صوتی با فواصل زمانی بسیار کوتاه، ایدهآل برای زیرنویس زنده و ترجمه همزمان جلسات چندنفره.
- مدیریت پیشرفته همپوشانی صدا (Overlapping Speech): مدل قادر است حتی زمانی که دو یا چند نفر همزمان صحبت میکنند، صدای هر فرد را بهدرستی ردیابی و تفکیک کند.
- کاهش نرخ خطای تفکیک (DER – Diarization Error Rate): طبق تستهای استاندارد، این مدل دقت بالاتری نسبت به نسلهای قبلی ارائه میدهد و اشتباهات ناشی از تشابه صدا را به حداقل میرساند.
- مقیاسپذیری و بهینهسازی مصرف منابع: با بهرهگیری از توان کارتهای گرافیک انویدیا، مدل میتواند صدها استریم صوتی همزمان را در دیتاسنترها مدیریت کند.
مقایسه مدلهای سنتی تفکیک صدا در برابر NVIDIA Nemotron 3
برای درک بهتر جهش فنی این مدل، میتوان مشخصات آن را در مقایسه با رویکردهای کلاسیک صوتی مرور کرد:
| ویژگی | روشهای سنتی تفکیک گوینده | مدل NVIDIA Nemotron 3 |
|---|---|---|
| نوع پردازش | غالباً آفلاین و پس از پایان ضبط | بلادرنگ (Real-Time) و همگام با گفتار |
| مدیریت صحبت همزمان | دچار خطا و ترکیب تگهای گوینده | جداسازی پیشرفته چند گوینده همزمان |
| تأخیر پردازش (Latency) | چند ثانیه تا چند دقیقه | میلیثانیه (مناسب استریم زنده) |
| یکپارچگی با ASR | مستلزم خط لولههای پیچیده مجزا | سازگاری بومی با مدلهای تبدیل گفتار به متن انویدیا |
کاربردهای تحولآفرین این فناوری در دنیای واقعی
توانایی تشخیص سریع و دقیق هویت گوینده در صوت، چندین حوزه کلیدی از اقتصاد دیجیتال را دگرگون میکند:
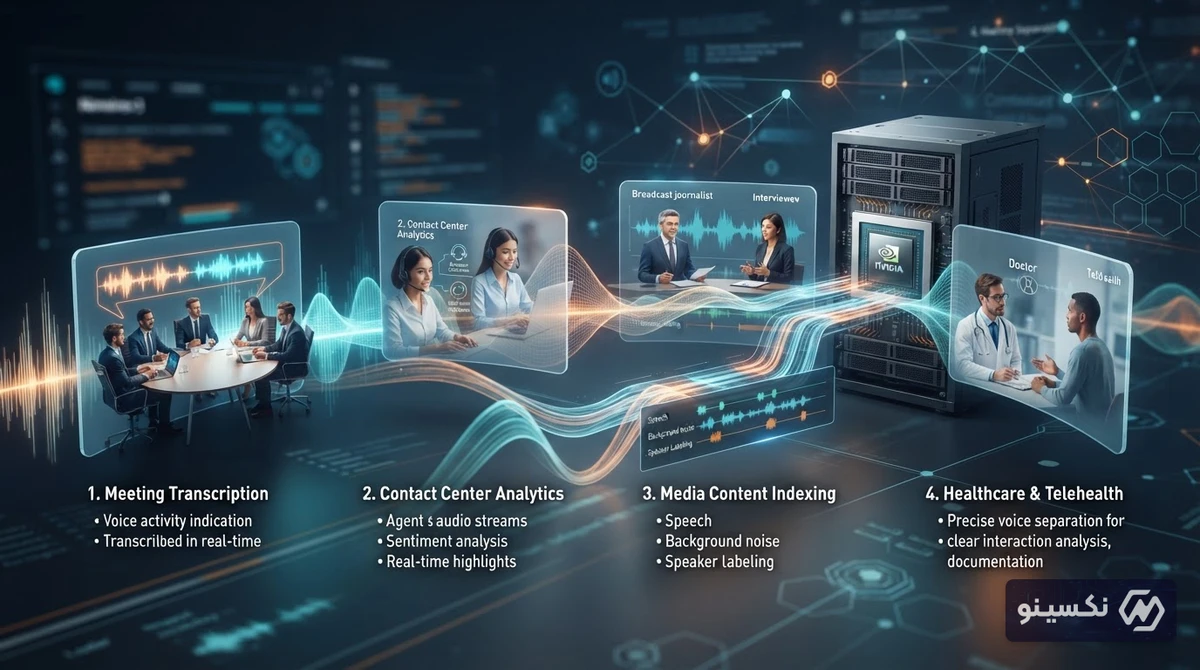
۱. خلاصهسازی و یادداشتبرداری هوشمند جلسات
پلتفرمهای ویدیوکنفرانس نظیر زوم و مایکروسافت تیمز میتوانند با استفاده از این فناوری، مشخص کنند هر ایده یا مصوبه توسط چه کسی مطرح شده است، بدون اینکه نیازی به بررسی دستی صوت باشد.
۲. مراکز تماس و پشتیبانی مشتریان (Call Centers)
تفکیک بیدرنگ مکالمه کارشناس از مشتری باعث میشود سامانههای هوش مصنوعی تحلیل رفتار (Sentiment Analysis)، کیفیت پاسخگویی کارشناس و میزان رضایت کاربر را بلافاصله پس از ادای هر جمله بررسی کنند.
۳. زیرنویسگذاری هوشمند و برنامههای پخش زنده
در مناظرهها، پادکستها یا برنامههای زنده تلویزیونی، سیستم میتواند با اختصاص رنگ یا برچسب نام به هر سخنران، زیرنویسهایی بسیار خوانا و دقیق تولید کند.
فناوری تفکیک گوینده انویدیا، پلی حیاتی میان صوت خام و درک عمیق دادههای مکالمهای توسط مدلهای زبانی بزرگ (LLMs) میسازد.
تأثیر این دستاورد بر رقابت بازار هوش مصنوعی صوتی
ورود قدرتمند انویدیا به حوزه تخصصی پردازش صوت، زنگ خطری برای رقبایی است که صرفاً روی لایه نرمافزاری تکیه دارند. از آنجا که انویدیا کنترل کامل پشته فناوری (از سیلیکون و سختافزار گرفته تا کتابخانههای نرمافزاری TensorRT و مدلهای NeMo) را در اختیار دارد، راهحلهای این شرکت با هزینهای بهمراتب پایینتر و سرعتی بیشتر روی زیرساختهای ابری اجرا میشوند. این رویداد مسیر جدیدی را برای استارتاپها و پلتفرمهای SaaS باز میکند تا بدون نیاز به زیرساختهای سنگین تحقیقاتی، مدلهای صوتی سطح اول جهان را در محصولات خود ادغام کنند.
جمعبندی
معرفی مدل Nemotron 3 Diarization توسط انویدیا نشان میدهد که آینده هوش مصنوعی صرفاً در تولید متن خلاصه نمیشود، بلکه ادراک چندوجهی، پردازش بلادرنگ صدا و تعامل صوتی انسان با ماشین هسته تحولات بعدی خواهد بود. دستیابی به تفکیک همزمان گویندگان، گرهگشای نسل جدیدی از دستیارهای هوشمند در جلسات کاری، ارتباطات تجاری و رسانههای مدرن است.
سؤالات متداول
فناوری Speaker Diarization چیست؟
روشی بر پایه هوش مصنوعی است که سیگنالهای صوتی را بررسی کرده و تعیین میکند چه بخشی از مکالمه توسط کدام گوینده بیان شده است.
مزیت اصلی مدل Nemotron 3 Diarization نسبت به مدلهای قدیمی چیست؟
مزیت اصلی آن پردازش بلادرنگ (Real-Time)، تأخیر میلیثانیهای، دقت بسیار بالا و توانایی استثنایی در مدیریت صحبت همزمان چند نفر است.
آیا این مدل فقط روی کارتهای گرافیک انویدیا اجرا میشود؟
این مدل بهینهسازی ویژهای برای معماری GPUهای انویدیا و اکوسیستم NeMo دارد تا بیشترین سرعت و بهرهوری پردازشی حاصل شود.
این فناوری چه کمکی به مدلهای زبانی بزرگ (LLM) میکند؟
با برچسبگذاری دقیق هویت هر گوینده، متن ورودی به مدل زبانی دارای ساختار کاملاً واضحی از دیالوگها میشود و خلاصهسازی یا تصمیمگیری هوش مصنوعی با دقت بسیار بیشتری انجام میگیرد.