گوگل دیپمایند در تازهترین اقدام خود برای تحول در اکوسیستم هوش مصنوعی، از مدل متنباز، سبک و چندوجهی EmbeddingGemma 2 رونمایی کرد. این مدل نوین برای پر کردن شکاف عمیق میان پردازش متن و تصویر در سیستمهای جستجوی معنایی و پایگاههای برداری توسعه یافته است.
انقلاب در تعبیهسازی دادهها؛ چرا EmbeddingGemma 2 مهم است؟
در دنیای پردازش دادههای مدرن، مدلهای تعبیهسازی (Embedding Models) قلب تپنده موتورهای جستجوی معنایی، سیستمهای توصیهگر و ساختارهای بازیابی اطلاعات به شمار میروند. این مدلها ورودیهای پیچیده مانند جملات یا تصاویر را به بردارهای عددی متراکمی تبدیل میکنند که روابط معنایی میان مفاهیم را در ابعاد ریاضی حفظ مینمایند.
تا پیش از این، اکثر مدلهای تعبیهسازی متنباز و سبک تنها به دادههای متنی محدود بودند یا برای پردازش تصاویر به توان پردازشی بسیار سنگینی نیاز داشتند. گوگل دیپمایند با رونمایی از EmbeddingGemma 2 معادله را به نفع توسعهدهندگان مستقل و شرکتهای کوچکتر تغییر داده است. این مدل ادامهای بر خانواده محبوب و موفق مدلهای باز Gemma است که این بار با تمرکز ویژه بر درک همزمان تصویر و متن طراحی شده است.
ویژگیهای برجسته و معماری فنی مدل جدید دیپمایند
بر اساس اطلاعات منتشرشده توسط تیم پژوهشی گوگل، EmbeddingGemma 2 با وجود وزن سبک و حجم کم، دقت فوقالعادهای در نگاشت معنایی ارائه میدهد. ساختار معماری این مدل به گونهای بهینهسازی شده که حتی روی سختافزارهای تجاری معمولی و سرورهای محلی (On-Premise) نیز قابل اجرا باشد.
قابلیتهای کلیدی مدل در یک نگاه:
- پشتیبانی واقعی از چندوجهی (Multimodality): توانایی مقایسه مستقیم متن و تصویر در یک فضای برداری مشترک، بدون نیاز به مدلهای مترجم جداگانه.
- وزن سبک و مصرف بهینه حافظه: کاهش چشمگیر حافظه رم و توان محاسباتی مورد نیاز در مقایسه با مدلهای تجاری ابری.
- دقت بالا در مقیاسگذاری متنی و بصری: عملکرد برجسته در بنچمارکهای استاندارد ارزیابی بردارهای معنایی (MTEB).
- انعطاف در سیستمهای RAG: بهبود سرعت و دقت سیستمهای تولید متن مبتنی بر بازیابی (Retrieval-Augmented Generation).
جدول مشخصات و مقایسه کاربردی EmbeddingGemma 2
برای درک بهتر جایگاه این مدل در بازار هوش مصنوعی، جدول زیر مشخصات و مزایای آن را در مقایسه با مدلهای سنتی خلاصه میکند:
| شاخص | مدلهای تعبیه سنتی | مدل EmbeddingGemma 2 |
|---|---|---|
| نوع داده ورودی | صرفاً متنی (Text-only) | چندوجهی یکپارچه (متن + تصویر) |
| وضعیت دسترسی | اغلب مبتنی بر API ابری اختصاصی | متنباز و قابل دانلود برای اجرای محلی |
| هزینه استقرار | وابسته به مصرف توکن ابری | بسیار اقتصادی و بهینه روی سختافزار معمولی |
| کاربرد اصلی | جستجوی اسناد متنی ساده | جستجوی محتوای بصری، RAG چندرسانهای، کاتالوگهای فروشگاهی |
دگرگونی سیستمهای RAG و جستجوی بصری در مقیاس صنعتی
یکی از داغترین مباحث در مهندسی نرمافزار امروز، استفاده از معماری RAG برای متصل کردن مدلهای زبانی بزرگ (LLM) به پایگاههای دانش محلی شرکتهاست. چالش بزرگ سیستمهای RAG همواره ناتوانی در درک اسناد حاوی دیاگرام، تصاویر محصول یا جداول بصری بود.
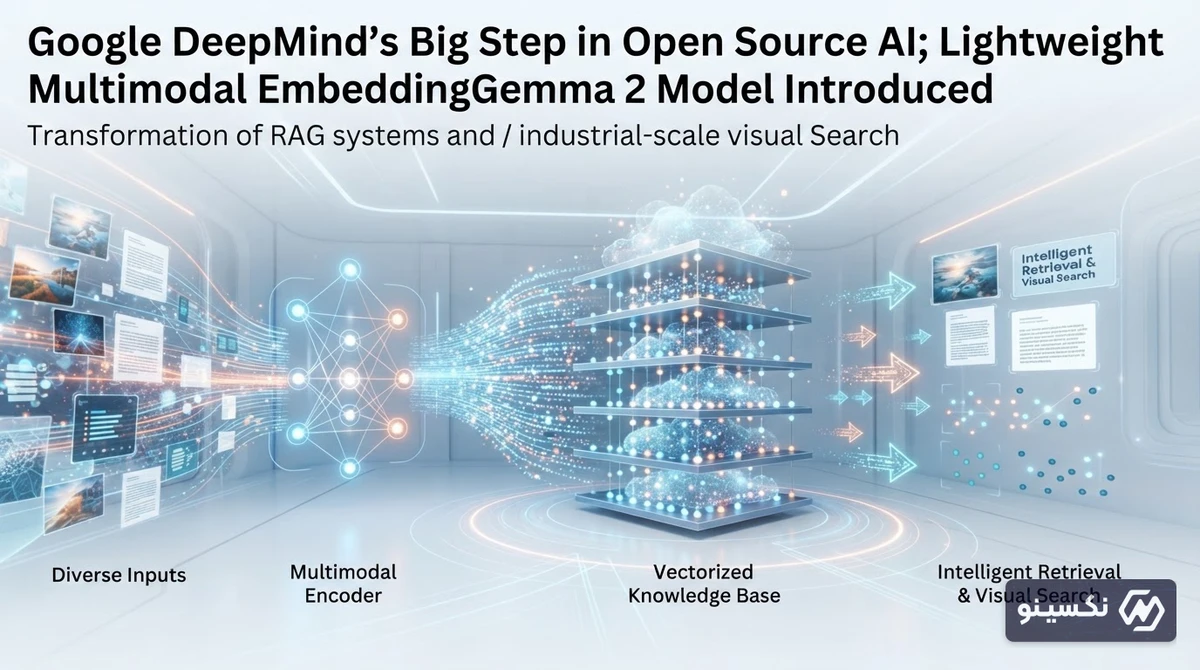
مدلهای تعبیهسازی چندوجهی منبعباز مانند EmbeddingGemma 2 نقطه عطفی برای ساخت موتورهای جستجوی اسناد پیچیده هستند؛ جایی که تصویر و متن ارزش اطلاعاتی برابری دارند.
با ورود EmbeddingGemma 2، توسعهدهندگان میتوانند کاتالوگهای چندرسانهای را بهراحتی فهرستبندی (Index) کرده و جستجوهایی از نوع «متن به تصویر» یا «تصویر به متن» را با کمترین تاخیر پردازشی پیادهسازی کنند.
تاثیر بر بازار هوش مصنوعی و رقابت با مدلهای انحصاری
اقدام اخیر گوگل را میتوان پاسخی استراتژیک به تسلط مدلهای انحصاری غولهای رقیب دانست. در شرایطی که دسترسی به سرویسهای ابری هزینهبر بوده و با چالشهای حریم خصوصی دادهها همراه است، ارائه یک مدل باز قدرتمند به کسبوکارها اجازه میدهد دادههای حساس خود را بدون خروج از سرورهای داخلی پردازش و تعبیهسازی کنند.
این استراتژی نه تنها موقعیت گوگل دیپمایند را در میان جامعه منبعباز تقویت میکند، بلکه سرعت پذیرش فناوریهای مبتنی بر هوش مصنوعی را در استارتاپها دوچندان خواهد کرد.
جمعبندی
معرفی EmbeddingGemma 2 نشاندهنده تعهد جدی گوگل دیپمایند به گسترش هوش مصنوعی چندوجهی، کارآمد و منبعباز است. این مدل سبک به توسعهدهندگان این امکان را میدهد تا بدون نیاز به زیرساختهای گرانقیمت ابری، به پیشرفتهترین فناوریهای جستجوی معنایی و سیستمهای RAG چندرسانهای دست یابند و آینده نسل جدید نرمافزارهای هوشمند را رقم بزنند.
سؤالات متداول
مدل EmbeddingGemma 2 چیست؟
یک مدل هوش مصنوعی متنباز و سبک از گوگل دیپمایند است که متن و تصویر را به بردارهای عددی متراکم برای جستجوی معنایی و بازیابی اطلاعات تبدیل میکند.
چرا چندوجهی بودن مدل تعبیهسازی اهمیت دارد؟
چندوجهی بودن به مدل امکان میدهد متن و تصویر را در یک فضای برداری واحد مقایسه کند و کاربردهایی مانند جستجوی تصاویر با متن یا بازیابی اسناد حاوی دیاگرام را ممکن سازد.
آیا اجرای EmbeddingGemma 2 نیازمند سرورهای گرانقیمت است؟
خیر، این مدل به صورت فوقالعاده سبک و بهینهسازیشده طراحی شده تا امکان اجرا بر روی سختافزارهای تجاری معمولی و سرورهای محلی را داشته باشد.
این مدل چه کاربردی در سیستمهای RAG دارد؟
به سیستمهای بازیابی اطلاعات امکان میدهد پایگاههای دانش حاوی متن و عکس را به طور همزمان و دقیق برای پاسخدهی به مدلهای زبانی فراهم کنند.