در دنیایی که هر هفته با معرفی یک مدل جدید زبانی شگفتزده میشویم، یک پرسش حیاتی همواره بیپاسخ مانده است: سرعت واقعی پیشرفت هوش مصنوعی در پشت درهای بسته آزمایشگاههای بزرگ چقدر است؟ شرکت انتروپیک (Anthropic)، توسعهدهنده خانواده مدلهای کلود (Claude)، با انتشار پژوهشی تازه، چارچوبی نوآورانه برای سنجش دقیق شتاب توسعه در «آزمایشگاههای مرزی» ارائه کرده است.
این گزارش تحلیلی نشان میدهد که معیارهای سنتی و بنچمارکهای عمومی دیگر توانایی بازتاب سرعت شگفتانگیز تحولات را ندارند. رویکرد جدید انتروپیک نهتنها پرده از نحوه ارزیابی قابلیتهای نسل بعدی برمیدارد، بلکه زنگ خطری جدی درباره لزوم آمادگی در حوزههای ایمنی، سیاستگذاری و بازار کار به صدا درمیآورد.
چرا بنچمارکهای سنتی دیگر پاسخگوی سنجش هوش مصنوعی نیستند؟
تا چند سال پیش، آزمونهایی مانند MMLU (درک چندوظیفهای زبان) یا HumanEval معیارهای طلایی برای ارزیابی قدرت مدلهای هوش مصنوعی به شمار میرفتند. با این حال، با جهش ناگهانی معماری ترنسفورمر و بهینهسازیهای پسآموزش، مدلهای پیشرو این آزمونها را در مدتزمانی بسیار کوتاهتر از پیشبینیها اشباع کردند. به این پدیده در علوم کامپیوتر «اشباع بنچمارک» گفته میشود؛ وضعیتی که در آن آزمون دیگر توانایی تفکیک تفاوت میان یک مدل عالی و یک مدل فوقالعاده را ندارد.
انتروپیک در گزارش جدید خود تأکید میکند که تکیه بر آزمونهای ایستا، تصویری گمراهکننده از واقعیت ارائه میدهد. آزمایشگاههای پیشرو یا Frontier Labs برای درک مسیر پیشرو، نیازمند شاخصهایی پویا هستند که سرعت خودکارسازی وظایف پیچیده، حل مسئله در مقیاسهای زمانی طولانی و توانایی تفکر مستقل را ارزیابی کنند.
معیارهای درونی؛ انتروپیک در آزمایشگاههای مرزی چه چیزی را رصد میکند؟
چارچوب ارائهشده از سوی انتروپیک بر اندازهگیری متغیرهایی تمرکز دارد که مستقیماً به بهرهوری علمی و قابلیتهای عام سیستمهای هوش مصنوعی مربوط میشوند. برخلاف آزمونهای چهارگزینهای، این معیارها بر پایه سناریوهای جهان واقعی طراحی شدهاند:
- افق زمانی انجام وظایف (Task Horizon): مدلی که بتواند یک وظیفه نیازمند چند ساعت تلاش انسانی متوالی (مانند عیبیابی یک پایگاه کد بزرگ یا نگارش یک مقاله علمی مستند) را بدون دخالت انسان انجام دهد، وارد فاز جدیدی از استقلال عملیاتی شده است.
- سرعت یادگیری درونبستری (In-Context Learning Speed): توانایی مدل در انطباق با ابزارها و مستندات نرمافزاری کاملاً جدید در کسری از ثانیه.
- شتاب تحقیقاتی (Research Velocity): مقایسه مدتزمان لازم برای رسیدن به یک دستاورد پژوهشی معین در مقایسه با چرخههای تحقیق سنتی.
حلقه بازخوردی: وقتی هوش مصنوعی، هوش مصنوعی میسازد
یکی از هیجانانگیزترین و در عین حال چالشبرانگیزترین بخشهای تحلیل انتروپیک، اشاره به پدیده تسریع درونزا است. هنگامی که مهندسان از مدلهای هوش مصنوعی برای کدنویسی سریعتر، پالایش دادههای آموزشی و طراحی معماریهای بهینهتر استفاده میکنند، چرخه توسعه مدلهای بعدی با شتابی نمایی کوتاه میشود. این خودکارسازی نسبی فرایند تحقیق و توسعه، اندازهگیری سرعت پیشرفت را از یک تخمین خطی ساده به یک مدلسازی پیچیده ریاضی تبدیل کرده است.
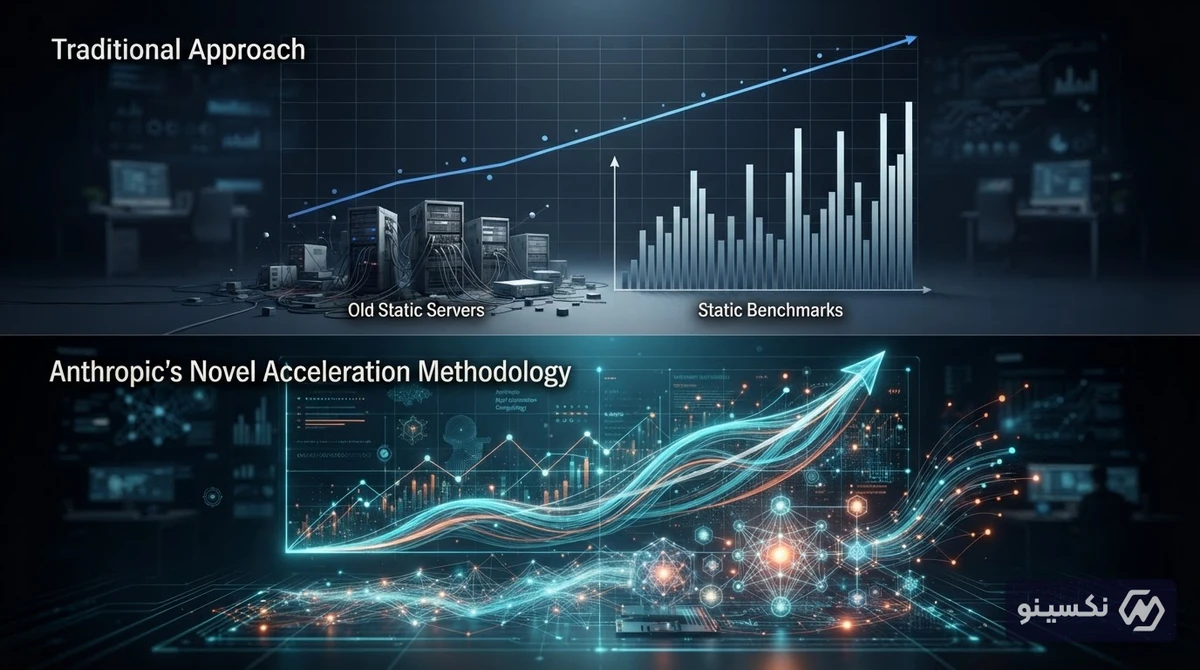
مقایسه رویکرد سنتی با متدولوژی سنجش نوین انتروپیک
| شاخص ارزیابی | رویکرد سنتی (عمومی) | چارچوب جدید انتروپیک (درونی) |
|---|---|---|
| نوع دادهها | مجموعه دادههای ثابت و آزمونهای چندگزینهای | وظایف تعاملی، چندمرحلهای و متغیر در زمان |
| محیط تست | محیط ایزوله و شبیهسازیشده | محیطهای واقعی برنامهنویسی و پژوهش علمی |
| تمرکز سنجش | دانش سطحی و حفظیات مدل | قدرت استدلال، حل مسئله و استقلال عملکردی |
| افق پیشبینی | وضعیت فعلی در برابر رقبا | تخمین زمان دسترسی به خودکارسازی کامل وظایف |
تأثیر این یافتهها بر رقابت غولهای فناوری و بازار جهانی
انتشار این متدولوژی صرفاً یک بحث آکادمیک نیست؛ بلکه پیامی آشکار به سرمایهگذاران و شرکتهای فعال در حوزه فناوری است. رقابت سنگین میان OpenAI با مدلهای سری o، گوگل با پروژه جیمنای، و انتروپیک با کلود، حالا به مرحلهای رسیده که شفافیت در اعلام معیارهای پیشرفت، به یک مزیت رقابتی تبدیل شده است.
شفافیت در اندازهگیری توانمندیهای مدلهای مرزی، کلید اصلی ایجاد اعتماد میان توسعهدهندگان، قانونگذاران و عموم جامعه است؛ نادیده گرفتن سرعت واقعی، ریسک غافلگیری فناورانه را چند برابر میکند.
برای کسبوکارها، این یافتهها به معنای کوتاه شدن چشمگیر پنجره زمانی تطبیق با ابزارهای خودکارسازی است. اگر مدلها بتوانند وظایف شناختی چندروزه را به چند دقیقه تقلیل دهند، ساختار سازمانی تیمهای مهندسی نرمافزار، پشتیبانی و تحلیل داده در کمتر از ۲ تا ۳ سال آینده دگرگون خواهد شد.
ابعاد ایمنی و نظارت؛ سنجش پیش از وقوع بحران
انتروپیک همواره به عنوان یکی از پیشگامان بحث «توسعه امن هوش مصنوعی» (AI Safety) شناخته میشود. در چارچوب جدید، یکی از کارکردهای اصلی سنجش سرعت، تشخیص زودهنگام آستانههای خطرناک است. این آستانهها شامل توانایی بالقوه مدلها در انجام حملات سایبری خودکار، تولید تسلیحات بیولوژیک یا فریب سیستمهای نظارتی است. اگر آزمایشگاهها ندانند سرعت پیشرفت سیستمهایشان دقیقاً چقدر است، نمیتوانند مکانیزمهای دفاعی لازم را پیش از انتشار مدلها تعبیه کنند.
جمعبندی
گزارش جدید انتروپیک هشداری هوشمندانه درباره تغییر ماهیت پیشرفت در صنعت هوش مصنوعی است. دیگر نمیتوان با بنچمارکهای قدیمی سرعت تحولات را سنجید. آزمایشگاههای پیشرو وارد عصری شدهاند که سرعت خودکارسازی وظایف پیچیده ذهنی، نه با سال و ماه، بلکه با روز و ساعت اندازهگیری میشود. درک این شتابسنج نهتنها برای پژوهشگران، بلکه برای رهبران کسبوکار و تصمیمگیرندگان حوزه فناوری یک ضرورت انکارناپذیر است تا بتوانند خود را برای مواجهه با نسل بعدی هوش عمومی آماده کنند.
سؤالات متداول
منظور از آزمایشگاههای مرزی (Frontier Labs) در حوزه هوش مصنوعی چیست؟
آزمایشگاههای مرزی به شرکتها و مراکزی مانند OpenAI، Anthropic و Google DeepMind گفته میشود که در لبه دانش هوش مصنوعی فعالیت کرده و پیشرفتهترین و قدرتمندترین مدلهای مقیاسبزرگ را آموزش میدهند.
چرا بنچمارکهای فعلی برای هوش مصنوعی ناکارآمد شدهاند؟
زیرا مدلهای جدید زبانی با سرعتی فراتر از انتظار توانستهاند در اکثر آزمونهای استاندارد مثل MMLU به نمرات نزدیک به ۱۰۰ برسند، در حالی که این آزمونها توانایی سنجش استدلال عمیق و کارکردهای چندساعته در دنیای واقعی را ندارند.
نوآوری اصلی انتروپیک در سنجش سرعت هوش مصنوعی چیست؟
تمرکز بر معیارهای عملیاتی نظیر افق زمانی انجام وظایف مستقل، شتاب پژوهشی و توانایی هوش مصنوعی در تسریع چرخه توسعه خودش، به جای استفاده از آزمونهای تستی و ایستا.
این سنجشهای جدید چه تأثیری بر امنیت هوش مصنوعی دارند؟
به پژوهشگران و نهادهای ناظر اجازه میدهند تا زمان رسیدن مدلها به قابلیتهای خطرناک (مانند حملات سایبری خودکار) را دقیقتر پیشبینی کرده و پروتکلهای امنیتی را پیش از وقوع ریسک فعال کنند.