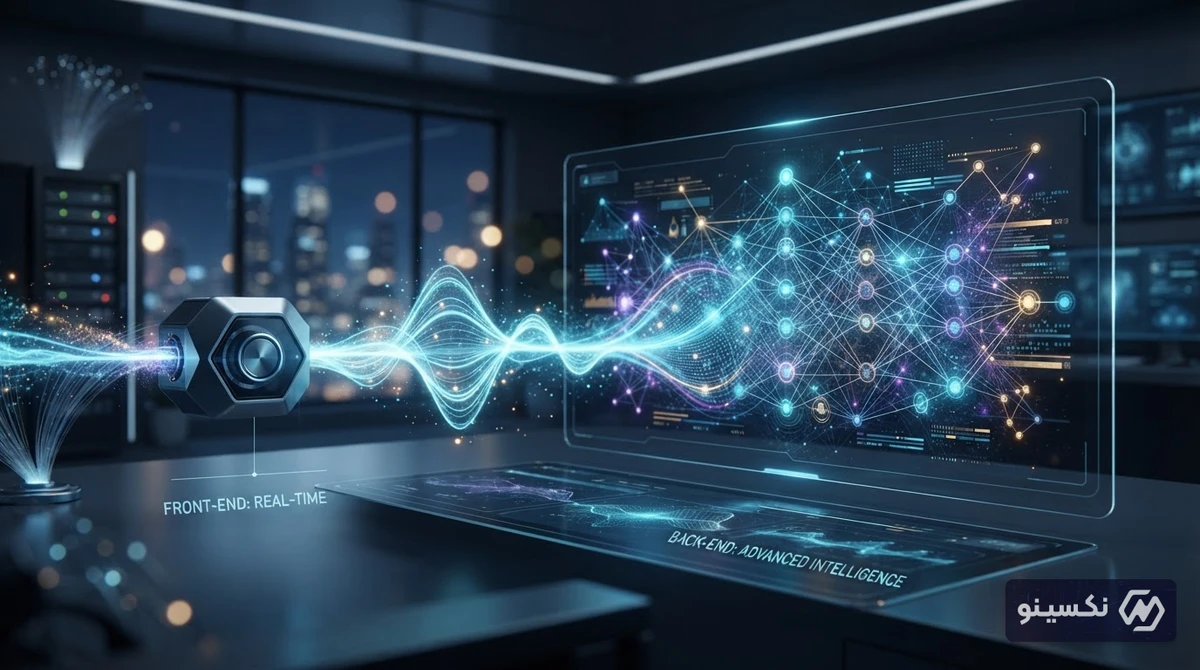
دستیارهای صوتی نسل جدید همواره میان دو راهی دشوار قرار داشتهاند: گفتوگوی روان و بلادرنگ بدون مکث، یا توانایی تفکر عمیق و اجرای ابزارهای پیچیده نرمافزاری. حالا یک مقاله پژوهشی پیشگامانه با معرفی معماری تفکیکشده «فرانتاند-بکاند»، راهکاری ارائه داده که توانسته مدلهای صوتی دوطرفه (Full-Duplex) را بدون افت سرعت، به قدرت مدلهای زبانی غولپیکر مجهز کند.
چالش بزرگ دستیارهای صوتی: تقابل سرعت مکالمه و قدرت تفکر
سیستمهای صوتی دوطرفه (Full-Duplex Speech-to-Speech) استانداردی طلایی در تعامل صوتی انسان و هوش مصنوعی به شمار میروند؛ جایی که کاربر میتواند همزمان با هوش مصنوعی صحبت کند، حرف آن را قطع نماید (Interruption Handling) و بدون هیچ مکث غیرطبیعی پاسخ بگیرد. با این حال، افزودن قابلیت اجرای ابزارها (Tool Calling) مانند رزرو بلیت، اتصال به تقویم یا جستوجو در وب، تا پیش از این باعث ایجاد تأخیر شدید و برهم خوردن روان بودن گفتوگو میشد.
مدلهای یکپارچه قبلی مجبور بودند یا مدلی سبک و سریع باشند که در استدلالهای پیچیده لنگ میزند، یا مدلی سنگین که پاسخ صوتی آن با تأخیر محسوس همراه است. پژوهش جدید با تفکیک ساختاری این دو بخش، پاسخی هوشمندانه به این معمای مهندسی ارائه داده است.
معماری فرانتاند-بکاند؛ تفکیک وظایف برای عملکرد حداکثری
ایده اصلی این پژوهش بر پایه یک استراتژی دو بخشی بنا شده است:
- بخش فرانتاند (Frontend): یک مدل صوتی سبک و دوطرفه که وظیفه مدیریت جریان گفتوگو، تشخیص گفتار به متن (ASR) استریمینگ، مدیریت نوبت صحبت و مدیریت قطع کلام را بدون هیچ تأخیری بر عهده دارد.
- بخش بکاند (Backend): یک مدل زبانی بزرگ متنی (LLM) بسیار قدرتمند که بهصورت تخصصی وظیفه فهم درخواستهای پیچیده و اجرای ابزارهای خارجی (API Calls) را انجام میدهد.
نحوه عملکرد توکن ارجاع (Delegation Token) و تزریق داده
فرانتاند صوتی هنگام دریافت دستور کاربر، با انتشار یک «توکن ارجاع»، متن پیادهشده را فوراً به مدل بکاند میفرستد. پس از آنکه بکاند ابزار مورد نظر را فراخوانی کرده و نتیجه را به دست آورد، دادهها از طریق مکانیزم نوآورانهای موسوم به Prefill-and-Repeat مجدداً به فرانتاند تزریق میشوند تا مدل صوتی استریمینگ (TTS) بلافاصله نتیجه را به صورت گفتار طبیعی به کاربر منتقل کند. این فرآیند چنان یکپارچه و بهینهسازی شده است که جریان طبیعی گفتوگو و امکان مداخله کاربر بههیچوجه مختل نمیشود.
برتری در بنچمارکها؛ شکست رقبای نامدار در آزمونهای واقعی
ارزیابیهای تجربی نشان میدهد این معماری به یکی از بالاترین نرخهای دقت در انجام وظایف صوتی دست یافته است. سیستم مذکور در ارزیابی فراخوانی ابزارها به بازخوانی (Recall) بین ۹۲ تا ۹۷ درصد و دقت ۸۱.۲ درصدی در رد درخواستهای نامربوط دست یافته است.
| شاخص ارزیابی | دستاورد معماری جدید | اهمیت فنی |
|---|---|---|
| فراخوانی موفق ابزار (Tool-Call Recall) | ۹۲٪ تا ۹۷٪ | اجرای بدون خطای دستورات کاربر |
| دقت رد ابزار نامربوط | ۸۱.۲٪ | جلوگیری از پاسخهای اشتباه و تداخل پردازشی |
| بنچمارک EVA-Bench | برتری محسوس | شکست مدلهای GPT-realtime-mini و Qwen3-Omni |
| بنچمارک Full-Duplex-Bench-V3 | عملکرد همرده و برتر | حفظ پایداری در مکالمات دوطرفه سریع |
نکته شگفتانگیز این است که وقتی این معماری با یک مدل قدرتمند مانند Qwen3-235B جفت شد، توانست در آزمونهای استاندارد بنچمارک EVA-Bench عملکردی به مراتب بالاتر از مدلهای مطرحی همچون GPT-realtime-mini و Qwen3-Omni-30B ثبت کند.
تأثیر این دستاورد بر آینده صنعت هوش مصنوعی صوتی
تا کنون شرکتهای بزرگ برای تولید دستیارهای صوتی به سمت آموزش مدلهای چندوجهی یکپارچه و گرانقیمت حرکت میکردند. این مقاله اثبات میکند که معماری ماژولار نهتنها کارآمدتر و اقتصادیتر است، بلکه امکان ارتقای مستقل مغز پردازشی (بکاند) را بدون نیاز به تغییر در بخش تعامل صوتی (فرانتاند) فراهم میسازد.
این نوآوری مسیر تجاریسازی دستیارهای صوتی مستقل در صنایعی چون خدمات مشتریان، خودروهای هوشمند و دستیارهای سازمانی را هموارتر از همیشه خواهد کرد.
جمعبندی
جداسازی هوشمندانه موتور تعامل صوتی از موتور استدلال متنی، گامی بنیادین بهسوی دستیارهای صوتی نسل آینده است. این معماری ماژولار به توسعهدهندگان اجازه میدهد بدون افت کیفیت و سرعت در مکالمه زنده، از پیشرفتهترین مدلهای هوش مصنوعی برای انجام کارهای پیچیده استفاده کنند؛ مسیری که آینده تعامل انسان و کامپیوتر را بیش از پیش طبیعی و کاربردی خواهد کرد.
سؤالات متداول
هوش مصنوعی صوتی دوطرفه (Full-Duplex) چیست؟
سیستمی که در آن کاربر و هوش مصنوعی میتوانند همزمان صحبت کنند، حرف یکدیگر را بدون ایجاد اختلال قطع کنند و مکالمهای با تأخیر ناچیز و کاملاً شبیه به گفتوگوی دو انسان داشته باشند.
چرا فراخوانی ابزارها (Tool Calling) در مدلهای صوتی قبلی چالشبرانگیز بود؟
زیرا اتصال به ابزارهای خارجی و پردازش دادهها زمانبر است و در مدلهای یکپارچه صوتی باعث ایجاد سکوتها و تأخیرهای غیرطبیعی میشد که روان بودن مکالمه را از بین میبرد.
معماری فرانتاند-بکاند چگونه این مشکل را حل میکند؟
با واگذاری وظیفه گفتوگو و تعامل سریع به فرانتاند صوتی سبک و سپردن پردازش ابزارها به یک مدل متنی سنگین در بکاند، بهگونهای که هیچ تأخیری به مکالمه صوتی کاربر تحمیل نشود.
این معماری چه تاثیری بر عملکرد مدل در برابر رقبایی مثل GPT Realtime دارد؟
بر اساس نتایج بنچمارکها، این معماری توانسته با بهرهگیری از مدلهای زبانی قدرتمند، سیستمهایی مثل GPT-realtime-mini را در تستهای EVA-Bench شکست دهد و دقت بالاتری در اجرای دستورات ثبت کند.