شرکت OpenAI در گزارشی امنیتی اعلام کرد یک کارزار سازمانیافته و هماهنگ را که با هدف استخراج غیرقانونی زنجیره تفکر مدلهای هوش مصنوعی (Protected Reasoning) اجرا شده بود، شناسایی و متوقف کرده است. این شیوه نفوذ که تحت عنوان «تقطیر خصمانه» (Adversarial Distillation) شناخته میشود، تلاشی مستقیم برای کپیبرداری از معماری استدلال پیشرفتهترین مدلهای هوش مصنوعی بدون صرف هزینههای کلان تحقیقوتوسعه است.
تقطیر خصمانه مدل چیست و چرا تهدیدی جدی است؟
در دنیای یادگیری ماشین، فرایند تقطیر مدل (Model Distillation) به روشی اشاره دارد که طی آن، خروجیها و نحوه تصمیمگیری یک مدل بزرگتر و قدرتمندتر به یک مدل کوچکتر آموزش داده میشود تا مدل دوم بتواند با حجم کمتر و هزینه پایینتر، عملکردی مشابه ارائه دهد. با این حال، هنگامی که این فرایند بهصورت غیرمجاز و مخفیانه علیه پلتفرمهای رقیب صورت گیرد، به یک حمله امنیتی و ضدرقابتی موسوم به تقطیر خصمانه تبدیل میشود.
مدلهای استدلالی نسل جدید نظیر سری o1 در OpenAI، فرایندی به نام زنجیره تفکر محافظتشده (Protected Reasoning) دارند؛ مسیری که در آن مدل گامبهگام مسئله را تحلیل میکند و این گامهای داخلی معمولاً از دید کاربر نهایی پنهان میماند. دسترسی به این استدلالهای پنهان، امکان بازتولید دقیق قابلیتهای مدل را برای رقبا فراهم میکند.
روش پیچیده مهاجمان برای دور زدن لایههای حفاظتی
بر اساس گزارش رسمی OpenAI، مهاجمان دیتابیس را هک نکرده یا رمزنگاری اصلی سرویس را نشکستهاند، بلکه با طراحی تعاملات هوشمندانه و دستکاری جریان پرامپتها، سیستم را فریب دادهاند تا بخشهای محافظتشده را بازتولید کند. برخی از تکنیکهای بهکاررفته در این حمله عبارتاند از:
- انتقال دادههای رمزگذاریشده بین مکالمات: کپی کردن تفکر رمزنگاریشده از یک نشست و وادار کردن مدل در نشستی دیگر به رمزگشایی و بازنویسی متن مخفی.
- فشردهسازی مکالمات (Conversation Compaction): بهرهگیری از تکنیکهای خلاصه و فشردهسازی تاریخچه برای نشت دادن دادههای محاسباتی پسزمینه.
- توزیع درخواستها در مقیاس وسیع: اجرای سناریوها از طریق هزاران حساب کاربری مختلف به منظور فرار از سیستمهای نظارتی و محدودیتهای نرخ مصرف (Rate Limit).
ابعاد و مقیاس حمله؛ از جولای تا توقف کامل
نشانههای اولیه این کارزار در اوایل ماه جولای شناسایی شد، اما نقطه اوج آن در ۲۴ و ۲۵ جولای رخ داد؛ جایی که بیش از ۱۶ هزار درخواست همشکل با الگوهای استخراج داده از سوی حدود ۴ هزار حساب کاربری هدایت شد. با گسترش دامنه بررسیها، خوشهای از بیش از ۱۵ هزار کاربر مرتبط کشف گردید که OpenAI توانست تا ۲۸ جولای فعالیت کل این شبکه را مسدود و مهار کند.
| شاخص | مقدار گزارششده | توضیحات |
|---|---|---|
| آغاز اولین فعالیتها | ۱ جولای | شروع نفوذ در مقیاس کم برای ارزیابی سامانه |
| اوج حملات | ۲۴ و ۲۵ جولای | ثبت بیش از ۱۶,۰۰۰ درخواست استخراج داده |
| تعداد کاربران متخلف اولیه | بیش از ۴,۰۰۰ کاربر | استفاده از الگوی پرامپتهای مهندسیشده |
| مجموع حسابهای مسدودشده | بیش از ۱۵,۰۰۰ اکانت | شناسایی کل خوشه مرتبط و توقف نهایی تا ۲۸ جولای |
ردپای بازیگران صنعت؛ ارتباط با استارتاپ چینی Moonshot AI
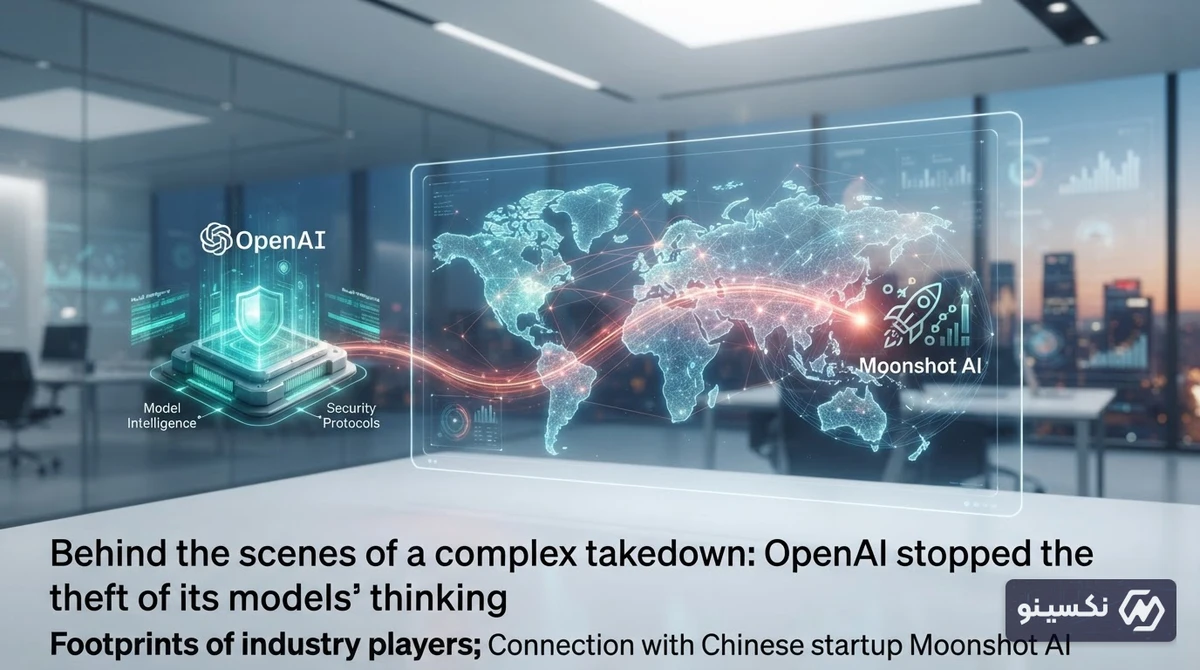
شرکت OpenAI اعلام کرده اگرچه مطمئن نیست تمام فعالیتها تنها توسط یک نهاد هدایت شده باشد، اما دادههای تحلیلی نشان میدهد که یک خوشه محوری و اصلی از این کمپین به افرادی وابسته به شرکت Moonshot AI (توسعهدهنده چتبات مشهور چینی Kimi) بازمیگردد. این موضوع نشاندهنده شدت گرفتن رقابتهای ژئوپلیتیک و فناورانه در حوزه هوش مصنوعی مولد است.
سرقت زنجیره تفکر مدلها میتواند به انتقال بیرویه و بدون نظارت فناوریهای دومنظوره (Dual-Use) منجر شود و خطرات ایمنی و امنیت ملی را تشدید کند.
پیامدها و اقدامات متقابل OpenAI
این شرکت علاوه بر بستن حسابهای کاربری متخلف و بازنگری در ساختار ثبتنام و شناسایی هویت، تدابیر جدیدی را برای حفاظت از مکالمات اتخاذ کرده است. همچنین اطلاعات فنی این شیوه حمله با اعضای انجمن مدلهای پیشرو (Frontier Model Forum) به اشتراک گذاشته شده تا سایر توسعهدهندگان نیز لایههای دفاعی خود را در برابر حملات مشابه تقویت کنند.
جمعبندی
حمله اخیر به OpenAI اثبات میکند که امنیت هوش مصنوعی صرفاً به حملات سایبری سنتی خلاصه نمیشود، بلکه محافظت از «دانش و تفکر درونی مدلها» چالش تازه دنیای فناوری است. با افزایش تلاش رقبا برای تقطیر مدلهای برتر، احتمالاً در آینده شاهد تدابیر سختگیرانهتر، پایش دقیقتر پرامپتها و نظارت سنگینتر بر دسترسی کاربران خواهیم بود.
سؤالات متداول
تقطیر خصمانه مدل (Adversarial Distillation) چیست؟
روشی غیرمجاز که در آن افراد یا شرکتها تلاش میکنند با استخراج زنجیره تفکر و خروجیهای یک مدل هوش مصنوعی پیشرفته، مدلهای خود را سریعتر و ارزانتر آموزش دهند.
آیا در این حمله اطلاعات خصوصی کاربران به سرقت رفته است؟
خیر؛ به گفته OpenAI هیچ پایگاه دادهای هک نشده و مهاجمان به مکالمات یا اطلاعات شخصی دیگر کاربران دسترسی پیدا نکردهاند.
تفکر محافظتشده (Protected Reasoning) چیست؟
مراحل داخلی و گامبهگامی است که مدلهای استدلالی هوش مصنوعی برای رسیدن به پاسخ نهایی طی میکنند و به دلایل امنیتی و مالکیتی از کاربر پنهان نگاه داشته میشود.
کدام شرکت به عنوان عامل احتمالی این حمله معرفی شده است؟
OpenAI هسته اصلی این عملیات را به افراد مرتبط با استارتاپ چینی Moonshot AI، سازنده چتبات Kimi، نسبت داده است.