توسعهدهندگان هاگینگ فیس (Hugging Face) در یک بهروزرسانی بزرگ، قابلیت اجرای مستقیم مدلهای کوانتایزشدهی llama.cpp و فایلهای فرمت GGUF را به کتابخانهی محبوب ترنسفورمرز (Transformers) اضافه کردند. این تحول فنی به کاربران اجازه میدهد تا سنگینترین مدلهای زبانی بزرگ (LLM) را با مصرف بهینهی رم، مستقیماً از طریق رابط برنامهنویسی آشنای پایتون روی لپتاپهای شخصی اجرا کنند.
تا پیش از این، برای بهرهمندی از سرعت خیرهکننده و مصرف پایین حافظه در پروژهی متنباز llama.cpp، توسعهدهندگان ناچار به استفاده از واسطهای اختصاصی یا کدهای زبان C++ بودند. اکنون با ادغام عمیق هستههای محاسباتی ggml در دل PyTorch و Transformers، فاصلهی میان اکوسیستم غنی پایتون و کارایی فوقالعادهی پردازش محلی از میان برداشته شده است.
یکپارچهسازی تاریخی؛ ترکیب انعطافپذیری Transformers با سرعت llama.cpp
کتابخانهی Transformers از شرکت هاگینگ فیس، سالهاست که ستون فقرات تحقیقات و توسعهی هوش مصنوعی در محیط پایتون به شمار میرود. با این حال، اجرای مدلهای عظیم متنی روی سختافزارهای تجاری و لپتاپهای فاقد کارتهای گرافیک گرانقیمت شرکتی، همواره چالشی جدی بوده است. از سوی دیگر، پروژهی تحسینشدهی llama.cpp که توسط گئورگی گرگانوف خلق شد، انقلابی در اجرای محلی هوش مصنوعی بر پایهی سختافزارهای مصرفی (مانند پردازندههای اینتل، AMD و تراشههای سری M اپل) ایجاد کرد.
با تغییرات اعمالشده در آخرین نسخهی Transformers، این دو دنیای قدرتمند با یکدیگر پیوند خوردهاند. کاربران اکنون میتوانند بدون نیاز به راهاندازی سرورهای مستقل یا تکیه بر بستههای جانبیِ ناسازگار، تنها با متد شناختهشدهی from_pretrained فایلهای فشردهشده با پسوند GGUF را مستقیماً از Hub هاگینگ فیس فراخوانی کرده و فرایند استنتاج (Inference) را با سرعت بالا آغاز کنند.
فرمت GGUF چیست و چرا استانداردی طلایی شد؟
برای درک اهمیت این خبر، باید نگاهی به ماهیت فایلهای GGUF بیندازیم. در مدلهای پیشفرض یادگیری ماشین، وزنهای شبکه بهصورت اعداد اعشاری ۱۶ بیتی (FP16) یا ۳۲ بیتی (FP32) ذخیره میشوند که برای یک مدل ۷ یا ۸ میلیارد پارامتری، به حداقل ۱۶ گیگابایت حافظهی VRAM اختصاصی نیاز دارد.
تکنیک کوانتیزاسیون (Quantization) این وزنها را به اعداد ۴ بیتی یا ۸ بیتی فشرده میکند، بدون اینکه افت کیفیت محسوسی در پاسخدهی هوش مصنوعی ایجاد شود. فرمت GGUF نسل جدید ذخیرهسازی این دادههاست که مزایای ساختاری زیر را به همراه دارد:
- یکپارچگی متادیتا: تمامی اطلاعات توکنایزر، هایپرپارامترها و معماری مدل در یک فایل واحد ذخیره میشوند.
- بارگذاری مستقیم در حافظه (mmap): مدلها بدون نیاز به تبدیل زمانبر در حافظه رم نگاشت میشوند که زمان بوت اولیه را به نزدیک صفر میرساند.
- سازگاری بینپلتفرمی: ساختار فایل بهگونهای است که هم روی پردازندههای مرکزی (CPU) و هم پردازندههای گرافیکی (GPU) بهینهترین خوانش را دارد.
مقایسه رویکرد سنتی با سازوکار جدید ترنسفورمرز
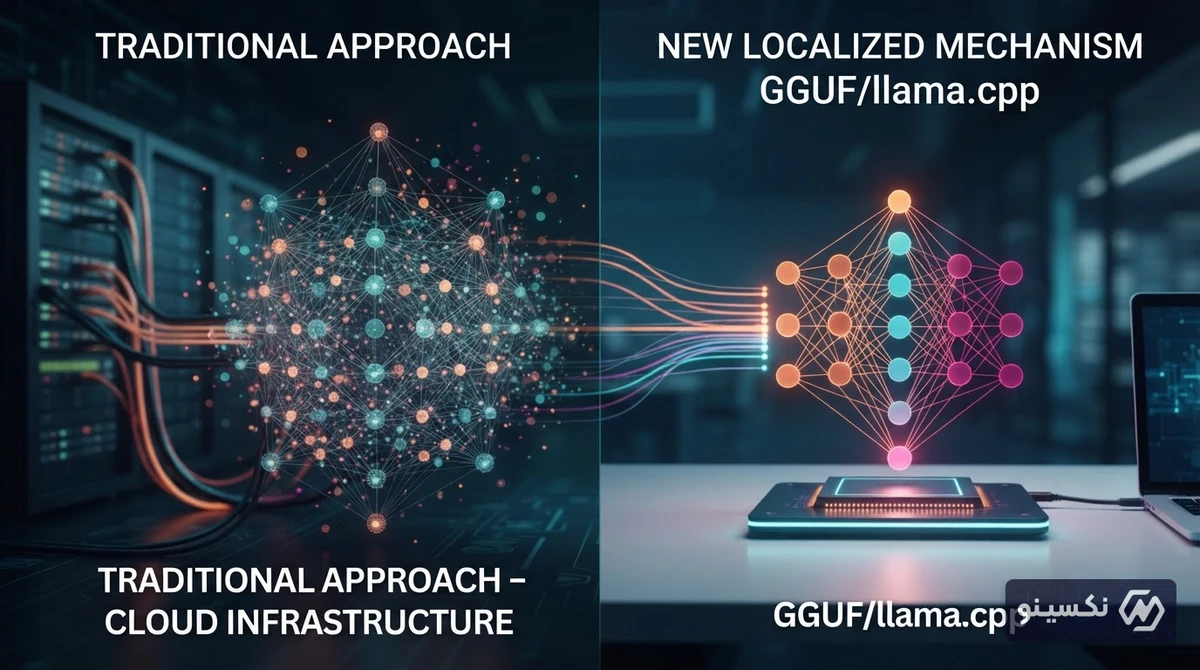
تا پیش از این ادغام، توسعهدهندگان باید بین دو راهیِ سرعت سختافزاری llama.cpp و سازگاری ابزاری Transformers یکی را انتخاب میکردند. جدول زیر تغییرات بنیادین حاصل از این قابلیت جدید را نشان میدهد:
| شاخص مقایسه | روش سنتی Transformers (FP16) | روش مستقل llama.cpp | ترنسفورمرز با پشتیبانی GGUF (جدید) |
|---|---|---|---|
| میزان مصرف رم (مدل 8B) | بیش از ۱۶ گیگابایت VRAM | حدود ۴ تا ۶ گیگابایت RAM/VRAM | حدود ۴ تا ۶ گیگابایت RAM/VRAM |
| محیط کدنویسی | پایتون / PyTorch بومی | ++C، خط فرمان یا بایندرهای جانبی | پایتون / اکوسیستم بومی Hugging Face |
| انعطاف در پایپلاینها | بسیار بالا | محدود به ابزارهای C++ | بسیار بالا (پشتیبانی از تمام توابع کمکی) |
| استفاده از حافظه یکپارچه اپل | محدود به MPS استاندارد | فوقالعاده بهینه با کرنلهای Metal | بهرهگیری مستقیم از کرنلهای Metal |
معماری فنی؛ چطور کرنلهای ggml درون پایتورچ فعال میشوند؟
نکتهی کلیدی در توسعهی این ویژگی، عدم استفاده از روشهای ناکارآمدِ شبیهسازی است. هاگینگ فیس با بازنویسی و انتقال مستقیم کرنلهای بهینهسازیشدهی ggml به ساختار درونی Transformers، موفق شده است پردازش ماتریسی را بدون افت فریم اجرا کند.
در این سازوکار جدید:
- هستههای Metal در مکبوکها: هنگام اجرا روی سیستمعامل macOS، ترنسفورمرز از محاسبات بهینهی Metal شتابگرفتهی ggml برای کار با GPU مجتمع پردازندههای اپل سیلیکون استفاده میکند.
- محاسبات موازی CPU و GPU: بخشهایی از لایهها که نیاز به پردازش سریع دارند به شتابدهنده گرافیکی منتقل شده و همزمان بقیهی ساختار با حداقل تاخیر در حافظه اصلی مدیریت میشود.
- یکپارچگی با توکنایزرهای سریع: توکنایزرهای Rust هاگینگ فیس بهطور خودکار با ساختار لغتنامهی GGUF همگام شده و نیازی به پیکربندی دستی ندارند.
تاثیر این قابلیت بر بازار توسعهی نرمافزار و هوش مصنوعی لبه (Edge AI)
این تحول تنها یک ارتقای فنی ساده نیست، بلکه مسیر تجاریسازی هوش مصنوعی را دگرگون میکند. در ۲۴ ساعت گذشته، جامعهی متنباز واکنشهای بسیار مثبتی نشان داده است؛ زیرا نیاز به سرورهای ابری گرانقیمت مبتنی بر تراشههای انویدیا (مانند A100 یا H100) برای تست، توسعه و دیپلوی سرویسهای سبک کاهش مییابد.
ادغام مستقیم قابلیت کوانتایزیشنِ بومی در پایتون، مرز میان نمونهسازی آزمایشی و اجرای محلیِ پرسرعت را از میان برداشته و حاکمیت دادهها را در محیطهای محلی تضمین میکند.
استارتاپها، تیمهای توسعه نرمافزار سازمانی و پژوهشگرانی که با محدودیتهای حریم خصوصی (عدم ارسال داده به APIهای ابری نظیر OpenAI) روبهرو هستند، اکنون میتوانند دستیارهای هوشمند، تحلیلگران اسناد و ابزارهای کدنویسی خود را کاملاً بهصورت آفلاین و با کمترین هزینه زیرساختی پیادهسازی کنند.
محدودیتهای نسخه اولیه و گامهای پیشرو
با وجود پیشرفت چشمگیر، تیم هاگینگ فیس اعلام کرده که این قابلیت در آغاز مسیر است. در حال حاضر معماریهای پرکاربردی مانند Llama 3، Mistral و Qwen بالاترین سطح سازگاری را دارند، اما پوشش کاملِ تمام مدلهای چندوجهی (Multimodal) و ساختارهای نامتعارفِ هوش مصنوعی در آپدیتهای هفتگی افزوده خواهد شد. علاوهبر این، بهینهسازیهای بیشتری برای کرنلهای CUDA در پردازندههای گرافیکی انویدیا در دست توسعه است تا کاربران ویندوز و لینوکس نیز به حداکثر توان کارتهای سری RTX دست یابند.
جمعبندی
پشتیبانی رسمی کتابخانه Transformers از مدلهای کوانتایزشدهی GGUF و موتور llama.cpp، نقطهی عطفی در دموکراتیزه کردن هوش مصنوعی است. این قابلیت با ترکیب سرعت C++ و سادگی پایتون، سد بزرگ سختافزارهای گرانقیمت را میشکند و اجرای امن، سریع و محلی مدلهای زبانی را برای همهی توسعهدهندگان به واقعیت تبدیل میکند.
سؤالات متداول
فرمت GGUF چیست و چه مزیتی در هوش مصنوعی دارد؟
فرمت GGUF یک ساختار فایل استاندارد برای ذخیره مدلهای زبانی فشردهشده (کوانتایز شده) است که اجازه میدهد مدلهای بزرگ با رم بسیار کم و سرعت بالا روی پردازندههای معمولی و لپتاپها اجرا شوند.
آیا برای اجرای فایلهای GGUF در ترنسفورمرز نیاز به نصب مجزای llama.cpp است؟
خیر؛ هاگینگ فیس کرنلهای موردنیاز را مستقیماً با کتابخانهی Transformers و PyTorch یکپارچه کرده و نیازی به کامپایل یا نصب جداگانهی کدهای C++ نیست.
آیا استفاده از مدلهای کوانتایز شده باعث افت شدید کیفیت پاسخها میشود؟
خیر؛ کوانتیزاسیونهای مدرن مانند 4-bit (بهویژه متدهای Q4_K_M یا Q8_0) کاهش حجم چشمگیری (تا حدود ۷۰ درصد) ایجاد میکنند، در حالی که کیفیت خروجی مدل در اکثر کاربردهای روزمره تقریباً بدون تغییر باقی میماند.
این ویژگی جدید روی چه دستگاههایی عملکرد بهتری دارد؟
این قابلیت روی تمامی سیستمها کار میکند، اما بهترین بهرهوری را روی مکبوکهای مجهز به تراشههای Apple Silicon (سری M) و کامپیوترهای مجهز به کارتهای گرافیک انویدیا با معماری سازگار ارائه میدهد.