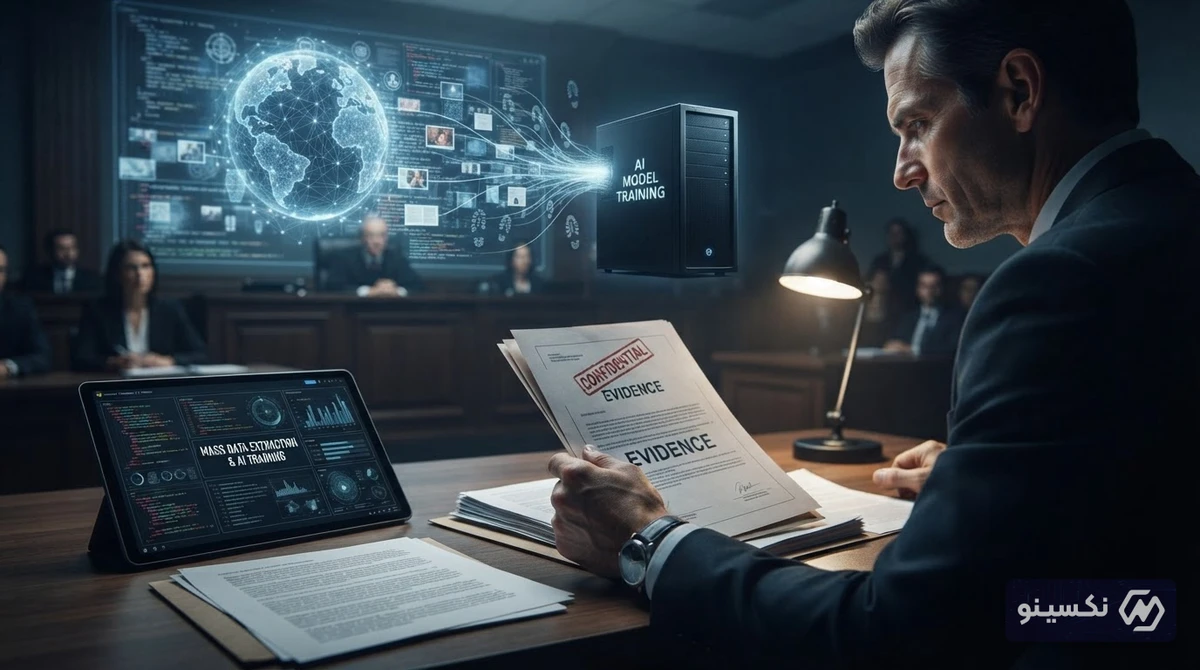
انتشار اسناد سانسورنشده از دادگاههای اخیر علیه غولهای هوش مصنوعی پرده از یک اعتراف تکاندهنده برداشته است؛ جایی که یکی از مدیران ارشد مایکروسافت، استخراج انبوه دادههای وب (Scraping) برای آموزش مدلهای هوش مصنوعی را بزرگترین سرقت دسترنج انسان در تمام طول تاریخ توصیف کرده است.
پردهبرداری از اسناد محرمانه؛ اعترافی تلخ پشت درهای بسته
در حالی که شرکتهای بزرگی نظیر مایکروسافت و OpenAI در مجامع عمومی و دادگاهها همواره از فرآیند آموزش مدلهای زبانی بزرگ (LLM) تحت عنوان «استفاده منصفانه» (Fair Use) دفاع میکنند، اسناد قضاییِ بهتازگی افشاشده روایتی کاملاً متناقض را به تصویر میکشند. این مدارک که پیشتر بخشهایی از آنها مخدوش و سانسور شده بود، نشان میدهند برخی چهرههای کلیدی در بدنه مدیریتی این شرکتها عمیقاً نسبت به ابعاد اخلاقی و حقوقی تاراج محتوای وب آگاه و نگران بودهاند.
عبارت «بزرگترین سرقت نیروی کار در تاریخ بشر» نه ادعای وکلای شاکی، بلکه اعتراف صریح یکی از مدیران ردهبالای مایکروسافت در مکاتبات داخلی بوده است؛ اعترافی که میتواند سرنوشت پروندههای حقوقی کپیرایت را دگرگون کند.
تناقض آشکار: ژستِ قانونی در دادگاه، اعتراف به سرقت در مکاتبات داخلی
شرکتهای هوش مصنوعی برای سالها بدون اجازه صاحبان اثر، حجم عظیمی از مقالات خبری، کتابها، کدهای برنامهنویسی و آثار هنری را از سرتاسر اینترنت جمعآوری و برای آموزش سیستمهایی چون ChatGPT و Copilot استفاده کردهاند. موضع رسمی این غولها همواره این بوده که یادگیری ماشین مانند مطالعه یک کتاب توسط انسان است و مشمول نقض کپیرایت نمیشود.
با این حال، اسناد تازه منتشرشده نشان میدهد مدیران ارشد در گفتوگوهای درونسازمانی اذعان داشتهاند که تبدیلِ بدون دستمزدِ دسترنج میلیونها نویسنده، خبرنگار و توسعهدهنده به محصولات تجاری چند میلیارد دلاری، پایههای اخلاقی و قانونی وب باز را ویران کرده است.
پیامدهای حقوقی این افشاگری بر نبرد غولهای فناوری
این افشاگری ضربه سنگینی به استراتژی دفاعی مایکروسافت و اوپنایآی در پروندههای مشهوری مانند شکایت روزنامه نیویورک تایمز و اتحادیههای نویسندگان وارد خواهد کرد. وکلای شاکی اکنون مدرکی مستند از درون خود مایکروسافت در دست دارند که نشان میدهد مدیران از آسیبهای این اقدام مطلع بودهاند.
مهمترین ابعاد تأثیر این افشاگری عبارتند از:
- تضعیف فرضیه «استفاده منصفانه»: اثبات آگاهی قبلی مدیران از تبعات سوءاستفاده از دادهها، ادعای حسننیت در استفاده منصفانه را با چالش جدی مواجه میکند.
- افزایش فشار برای عقد قراردادهای لایسنس: شرکتهای هوش مصنوعی مجبور خواهند شد برای فرار از جریمههای سنگین، مبالغ کلانی را به ناشران و رسانهها بابت حق استفاده از محتوا پرداخت کنند.
- تغییر رگولاتوری جهانی: نهادهای ناظر در اتحادیه اروپا و آمریکا احتمالاً قوانین سفتوسختتری برای شفافسازی دادههای آموزشی (Training Data) وضع خواهند کرد.
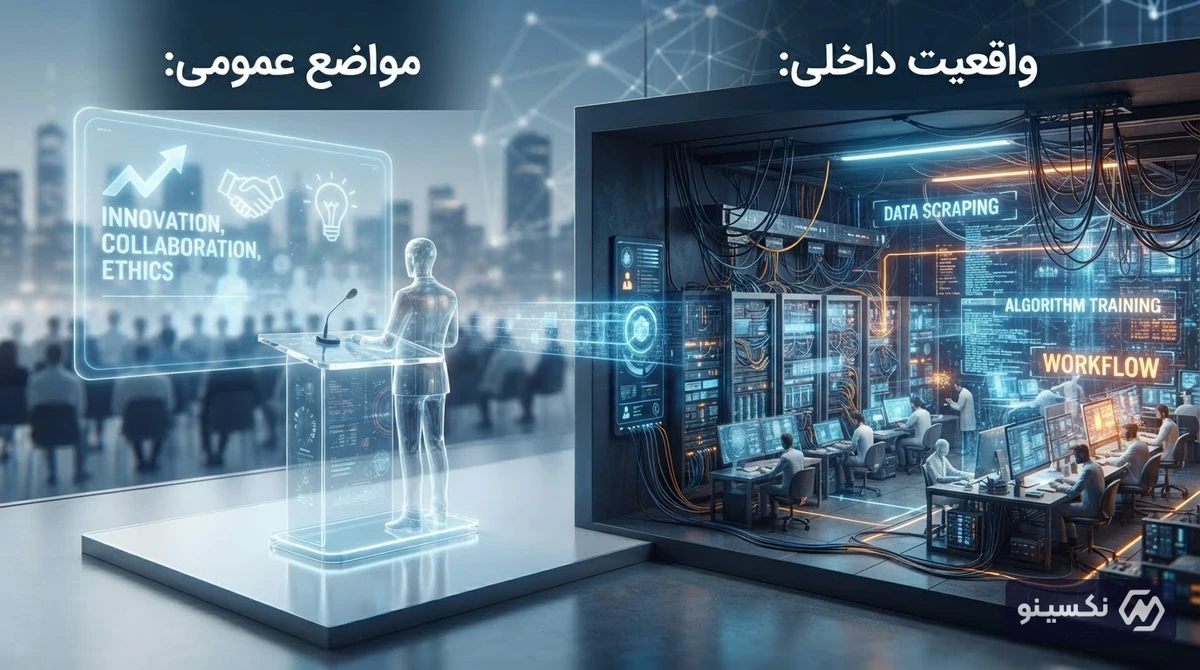
مقایسه مواضع عمومی و داخلی غولهای فناوری
| موضوع | موضع عمومی و رسانهای | محتوای اسناد و مکاتبات داخلی |
|---|---|---|
| جمعآوری دادهها (Scraping) | فرایندی استاندارد، قانونی و مصداق دسترسی آزاد به وب | بزرگترین سرقت نیروی کار و دسترنج انسانی در تاریخ |
| حق کپیرایت پدیدآورندگان | آموزش هوش مصنوعی ناقض کپیرایت نیست (استفاده منصفانه) | نگرانی شدید از دعواهای حقوقی و تضعیف موقعیت ناشران |
| پرداخت به صاحبان محتوا | اختیاری و تنها برای همکاریهای تجاری استراتژیک | یک ضرورت اجتنابناپذیر برای جلوگیری از شکست در دادگاه |
آینده اینترنت؛ از محتوای آزاد تا دیوارهای بسته
پیامد مستقیم این رویهها، واکنش تدافعیِ وبسایتها و پدیدآورندگان محتوا بوده است. امروزه بخش بزرگی از اینترنت به سمت پولیسازی (Paywalls)، مسدودسازی رباتهای خزشگر (Web Crawlers) و بستن دسترسیهای آزاد حرکت میکند. این تغییر پارادایم، اکوسیستم رایگان اینترنت را که در سه دهه گذشته منبع دانش جهانی بوده، با خطر جدی روبهرو کرده است.
جمعبندی
افشای این اسناد ثابت میکند که نبرد بر سر مالکیت دادهها در عصر هوش مصنوعی وارد مرحلهای سرنوشتساز شده است. غولهای فناوری دیگر نمیتوانند پشت توجیهات مبهم حقوقی پنهان شوند و آینده صنعت هوش مصنوعی نیازمند بازتعریف عادلانه حقوق پدیدآورندگان محتوا و جبران مادی دسترنج انسانی خواهد بود.
سؤالات متداول
چرا انتشار این سند محرمانه از مایکروسافت تا این حد خبرساز شده است؟
زیرا این سند اعتراف مستقیم یکی از بزرگترین سرمایهگذاران هوش مصنوعی به غیراخلاقی و ناعادلانه بودن جمعآوری رایگان دادههای وب است و ادعای دفاعی آنها در دادگاهها را به شدت تضعیف میکند.
اصطلاح AI Scraping به چه معناست؟
اسکرپینگ به فرآیند جمعآوری خودکار و انبوه اطلاعات، متون، تصاویر و کدهای منتشرشده در وبسایتهای اینترنتی برای استفاده در آموزش مدلهای هوش مصنوعی گفته میشود.
آیا این موضوع میتواند باعث توقف فعالیت سرویسهایی مثل ChatGPT شود؟
خیر، اما مدلهای تجاری شرکتها را وادار میکند تا مبالغ هنگفتی را تحت عنوان حق امتیاز و لایسنس به صاحبان محتوا پرداخت کنند و شفافیت دادههای آموزشی خود را افزایش دهند.
تاثیر این تحولات بر وب فارسی و تولیدکنندگان محتوای ایرانی چیست؟
با تشدید بحث مالکیت داده در جهان، ابزارهای محافظت از کپیرایت و روشهای جلوگیری از ایندکس غیرمجاز محتوا برای تمام وبسایتها از جمله پلتفرمهای فارسیزبان دردسترستر و جدیتر خواهد شد.